پرووید
آموزش پیشرفته مدل های زبانی بزرگ با استفاده از تولید تقویت شده با بازیابی (RAG)
آموزش پیشرفته مدل های زبانی بزرگ با استفاده از تولید تقویت شده با بازیابی با عنوان اصلی Advanced LLMs with Retrieval Augmented Generation (RAG) Practical Projects for AI Applications یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. در این آموزش با مفاهیم پیشرفته Retrieval Augmented Generation یا RAG و روش استفاده از آن برای توسعه برنامه های مبتنی بر هوش مصنوعی آشنا می شوید. همچنین با انجام تمرین های عملی، نحوه تبدیل متن و اسناد به بردارهای Embedding، تقسیم بندی هوشمند اسناد و بهبود فرایند بازیابی اطلاعات را یاد می گیرید.
تولید تقویت شده با بازیابی (RAG) چیست؟
Retrieval Augmented Generation یا RAG روشی برای ترکیب قابلیت های مدل های زبانی بزرگ (LLM) با سیستم های بازیابی اطلاعات است. در این معماری، به جای اینکه مدل صرفاً بر اساس دانش موجود در پارامترهای خود پاسخ تولید کند، ابتدا اطلاعات مرتبط از منابع خارجی مانند اسناد و پایگاه های داده بازیابی می شوند و سپس در اختیار مدل قرار می گیرند تا پاسخ دقیق تری بر اساس محتوای پیدا شده تولید کند. این روش امکان استفاده از اطلاعات اختصاصی و به روز را در برنامه های مبتنی بر هوش مصنوعی فراهم می کند.
درک اصول RAG برای توسعه برنامه هایی که به اطلاعات تخصصی یا مجموعه اسناد مشخص نیاز دارند اهمیت زیادی دارد. با این حال، پیاده سازی ساده RAG همیشه نتیجه مطلوبی ندارد و ممکن است در بازیابی اطلاعات مرتبط یا انتخاب محتوای مناسب برای تولید پاسخ با مشکل مواجه شود. شناخت محدودیت های این روش و بررسی یک نمونه عملی ساده، نقطه شروع مناسبی برای طراحی سیستم های پیشرفته تر است.
Embedding چیست و چه کاربردی در RAG دارد؟
Embedding یکی از مفاهیم اصلی در سیستم های مدرن بازیابی اطلاعات است. در این روش، متن، کلمات، جملات یا محتوای اسناد به بردارهای عددی تبدیل می شوند تا بتوان ارتباط معنایی میان بخش های مختلف محتوا را بررسی کرد. برخلاف جستجوی متنی ساده که معمولاً به تطابق کلمات وابسته است، جستجوی مبتنی بر Embedding می تواند شباهت معنایی میان عبارت های متفاوت را نیز تشخیص دهد و محتوای مرتبط تری را در اختیار سیستم قرار دهد.
برای استفاده مؤثر از Embedding باید با مفاهیمی مانند Tokenization، Vocabulary و Sentence Embedding آشنا باشید. همچنین Content Embedding به سیستم کمک می کند محتوای اسناد را به نمایش برداری تبدیل کند تا در مراحل بعدی قابل جستجو و بازیابی باشد. شناخت نحوه عملکرد این فرایندها به توسعه دهندگان کمک می کند درک بهتری از ارتباط میان متن ورودی، بردارهای تولیدشده و کیفیت نتایج بازیابی داشته باشند.
تقسیم بندی اسناد و راهبردهای Contextual Retrieval
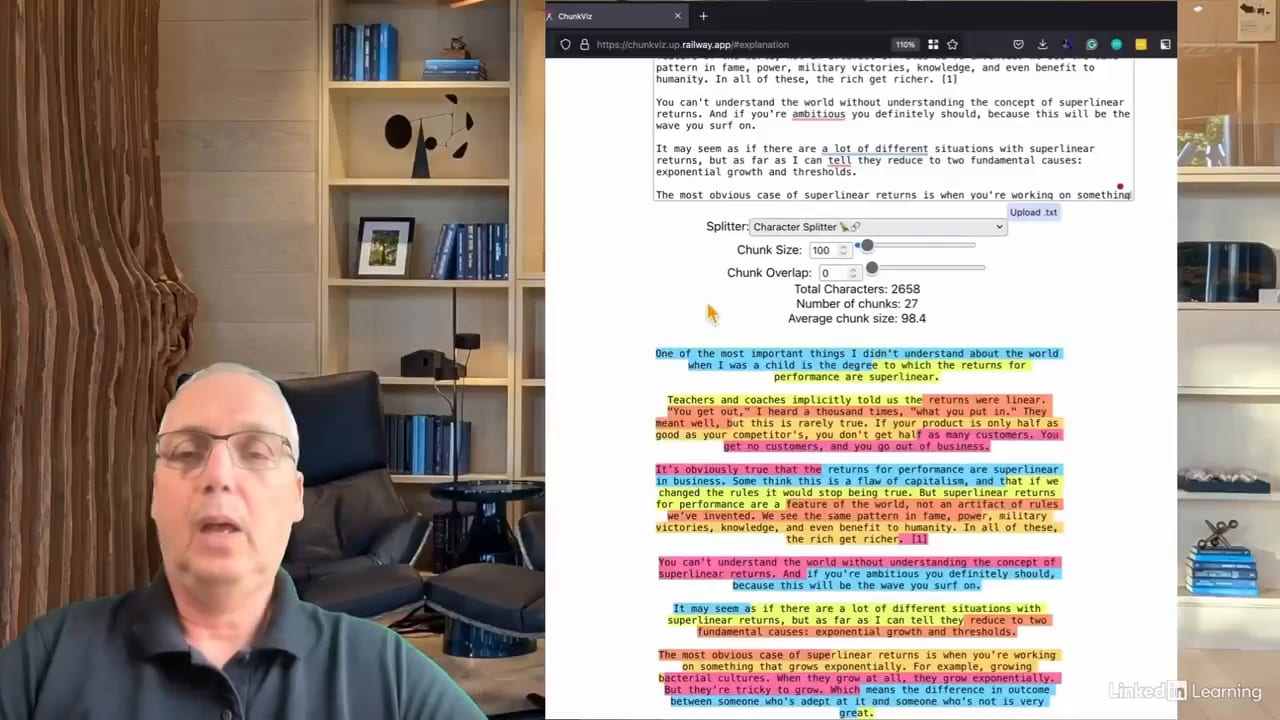
یکی از چالش های مهم در توسعه سیستم های RAG، نحوه تقسیم اسناد به بخش های کوچک تر یا Chunk است. اگر بخش بندی به شکل مناسبی انجام نشود، ممکن است ارتباط معنایی میان قسمت های مختلف متن از بین برود یا اطلاعات ضروری برای پاسخ گویی از دسترس مدل خارج شود. به همین دلیل، انتخاب راهبرد مناسب برای Chunking نقش مهمی در کیفیت بازیابی اطلاعات دارد. یکی از روش های پیشرفته در این زمینه Semantic Chunking است که به جای تکیه صرف بر تعداد کلمات یا اندازه ثابت، به معنای متن توجه می کند.
در کنار تقسیم بندی معنایی، Contextual Retrieval به حفظ و اضافه کردن اطلاعات زمینه ای به بخش های استخراج شده از اسناد کمک می کند. مفهوم Query Document Alignment نیز به ارتباط بهتر میان پرسش کاربر و محتوای اسناد مربوط است. همچنین روش Reverse HyDE رویکردی برای بهبود ارتباط میان پرسش و اسناد در فرایند بازیابی ارائه می دهد. آشنایی با این راهبردها به شما کمک می کند ساختار محتوای ورودی به سیستم RAG را متناسب با نیازهای جستجو و بازیابی طراحی کنید.
چگونه فرایند بازیابی اطلاعات در RAG را بهبود دهیم؟
کیفیت پاسخ در یک سیستم RAG تا حد زیادی به کیفیت اطلاعات بازیابی شده بستگی دارد. حتی اگر مدل زبانی توانایی بالایی در تولید متن داشته باشد، دریافت اسناد نامرتبط یا ناقص می تواند نتیجه نهایی را تحت تأثیر قرار دهد. یکی از روش های بهبود این فرایند Hybrid Search است که قابلیت های جستجوی مبتنی بر کلمات کلیدی و جستجوی معنایی را با یکدیگر ترکیب می کند. این ترکیب به سیستم اجازه می دهد از مزایای هر دو رویکرد برای پیدا کردن محتوای مرتبط استفاده کند.
روش دیگری که در بهبود نتایج بازیابی اهمیت دارد Reranking است. در این رویکرد، نتایج اولیه جستجو دوباره ارزیابی و بر اساس میزان ارتباط با پرسش کاربر مرتب می شوند تا اسناد مناسب تر در اولویت قرار بگیرند. همچنین Multimodal Retrieval امکان بازیابی اطلاعات از محتوای چندرسانه ای را فراهم می کند. برای مثال، در بازیابی اطلاعات از فایل های PDF چندرسانه ای ممکن است علاوه بر متن، ساختار بصری و محتوای تصویری سند نیز اهمیت داشته باشد. آشنایی با این قابلیت ها دید گسترده تری از طراحی سیستم های بازیابی پیشرفته به شما می دهد.
کاربردهای RAG در توسعه برنامه های هوش مصنوعی
RAG در برنامه هایی کاربرد دارد که باید پاسخ های خود را بر اساس منابع اطلاعاتی مشخص تولید کنند. برای مثال، می توان از این معماری در سیستم های پرسش و پاسخ درباره اسناد سازمانی، دستیارهای هوشمند مبتنی بر مستندات فنی و ابزارهای جستجوی معنایی در مجموعه های بزرگ اطلاعات استفاده کرد. در چنین برنامه هایی، بازیابی محتوای مرتبط پیش از تولید پاسخ به مدل کمک می کند به جای ارائه پاسخ های صرفاً عمومی، از اطلاعات موجود در منابع مورد نظر استفاده کند.
با ترکیب Embedding، Chunking، Contextual Retrieval و روش های پیشرفته جستجو می توان سیستم هایی طراحی کرد که در مواجهه با مجموعه های متنوع اسناد عملکرد مناسب تری داشته باشند. همچنین Hybrid Search و Reranking برای بهبود انتخاب اسناد و Multimodal Retrieval برای کار با محتوای فراتر از متن قابل استفاده هستند. این تکنیک ها در کنار یکدیگر بخش مهمی از ابزارهای مورد نیاز برای ساخت برنامه های کاربردی مبتنی بر LLM را تشکیل می دهند.
این آموزش پیشرفته RAG برای چه کسانی مناسب است؟
این آموزش برای برنامه نویسان و توسعه دهندگانی مناسب است که با مفاهیم اولیه هوش مصنوعی مولد و مدل های زبانی بزرگ آشنایی دارند و می خواهند دانش خود را در زمینه Retrieval Augmented Generation گسترش دهند. اگر قصد دارید برنامه هایی بسازید که بتوانند اطلاعات را از اسناد و منابع خارجی بازیابی کنند و از آن ها برای تولید پاسخ استفاده کنند، آشنایی با موضوعات این دوره می تواند به شما در درک بهتر اجزای چنین سیستم هایی کمک کند.
همچنین مهندسان هوش مصنوعی و توسعه دهندگانی که روی ساخت دستیارهای هوشمند، سیستم های پرسش و پاسخ و ابزارهای جستجوی مبتنی بر LLM کار می کنند، می توانند از مباحث این آموزش بهره ببرند. تمرکز بر مفاهیم پیشرفته و آزمایش های عملی در زمینه Embedding، تقسیم بندی اسناد، Hybrid Search، Reranking و Multimodal Retrieval به شما کمک می کند با روش های مختلف طراحی و بهبود سیستم های RAG آشنا شوید. این دوره به زبان انگلیسی ارائه شده و دارای زیرنویس انگلیسی است.
سرفصل مطالب آموزش ویدئویی پیشرفته مدل های زبانی بزرگ با استفاده از تولید تقویت شده با بازیابی (RAG)
فصل اول: مقدمه
- معرفی دوره
- آشنایی با مفاهیم پایه RAG
- ساخت یک نمونه ساده RAG
- چالشها و مشکلات RAG ساده
فصل دوم: تبدیل متن به بردارهای Embedding
- مقدمهای بر Embedding
- آزمایش عملی Tokenization در Embedding
- آزمایش عملی Vocabulary در Embedding
- آزمایش عملی Sentence Embedding
- آزمایش عملی Content Embedding
- مرور و جمعبندی Notebook مربوط به Embedding
فصل سوم: تقسیمبندی اسناد و راهبردهای غنیسازی محتوا
- مقدمهای بر Chunking
- آزمایش عملی Semantic Chunking
- مروری بر روشهای Chunking
- آزمایش عملی Contextual Retrieval
- همترازی Query و Document
- آزمایش عملی Reverse HyDE
فصل چهارم: بهبود بازیابی اسناد
- مقدمهای بر Hybrid Search
- آزمایش عملی Hybrid Search
- آزمایش عملی Reranking
- مقدمهای بر Multimodal Retrieval
- آزمایش عملی بازیابی چندوجهی اطلاعات از فایلهای PDF
محصولات مرتبط