پرووید
آموزش پایگاه داده های برداری برای Caching و تولید تقویت شده با بازیابی (RAG)
آموزش پایگاه داده های برداری برای Caching و تولید تقویت شده با بازیابی با عنوان اصلی LLM Foundations Vector Databases for Caching and Retrieval Augmented Generation (RAG) یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. در این آموزش با مفاهیم پایگاه داده های برداری و نحوه استفاده از آن ها در کنار Large Language Models آشنا می شوید. همچنین کار با Milvus، مدیریت و جستجوی داده های برداری، استفاده از Vector Database برای Caching و پیاده سازی معماری Retrieval Augmented Generation را یاد می گیرید. در ادامه نیز با روش های انتخاب و بهینه سازی پایگاه داده های برداری آشنا خواهید شد.
پایگاه داده برداری (Vector Database) چیست؟
پایگاه داده برداری نوعی پایگاه داده است که اطلاعات را به شکل Vector ذخیره و مدیریت می کند. در این روش، داده ها با استفاده از مدل های مختلف به نمایش های عددی تبدیل می شوند تا بتوان ارتباط معنایی میان آن ها را بررسی کرد. برای مثال، در پردازش زبان طبیعی (NLP)، متن ها به Vectorهایی تبدیل می شوند که ویژگی های معنایی آن ها را نمایش می دهند. این قابلیت باعث می شود جستجو فقط به تطبیق دقیق کلمات محدود نباشد.
یکی از مهم ترین قابلیت های این پایگاه داده ها، Vector Similarity Search است. با استفاده از این روش می توان داده هایی را پیدا کرد که از نظر معنایی یا برداری به یک ورودی مشخص نزدیک تر هستند. در این آموزش با مفهوم Vector، فرایند Vectorization در NLP و نحوه انجام جستجوی شباهت آشنا می شوید. همچنین مزایا و محدودیت های Vector Database را بررسی می کنید تا بتوانید کاربردهای مناسب این فناوری را در پروژه های هوش مصنوعی تشخیص دهید.
آموزش Milvus و معماری پایگاه داده برداری
Milvus یکی از ابزارهای تخصصی برای ذخیره سازی و جستجوی داده های برداری است که در پروژه های مبتنی بر هوش مصنوعی کاربرد دارد. برای استفاده مؤثر از این ابزار، ابتدا باید با معماری آن و نحوه سازمان دهی داده ها آشنا شوید. مفاهیمی مانند Collection و Partition به شما کمک می کنند داده ها را ساختاردهی و مدیریت کنید. همچنین Indexها نقش مهمی در بهبود فرایند جستجو و دسترسی به داده های برداری دارند.
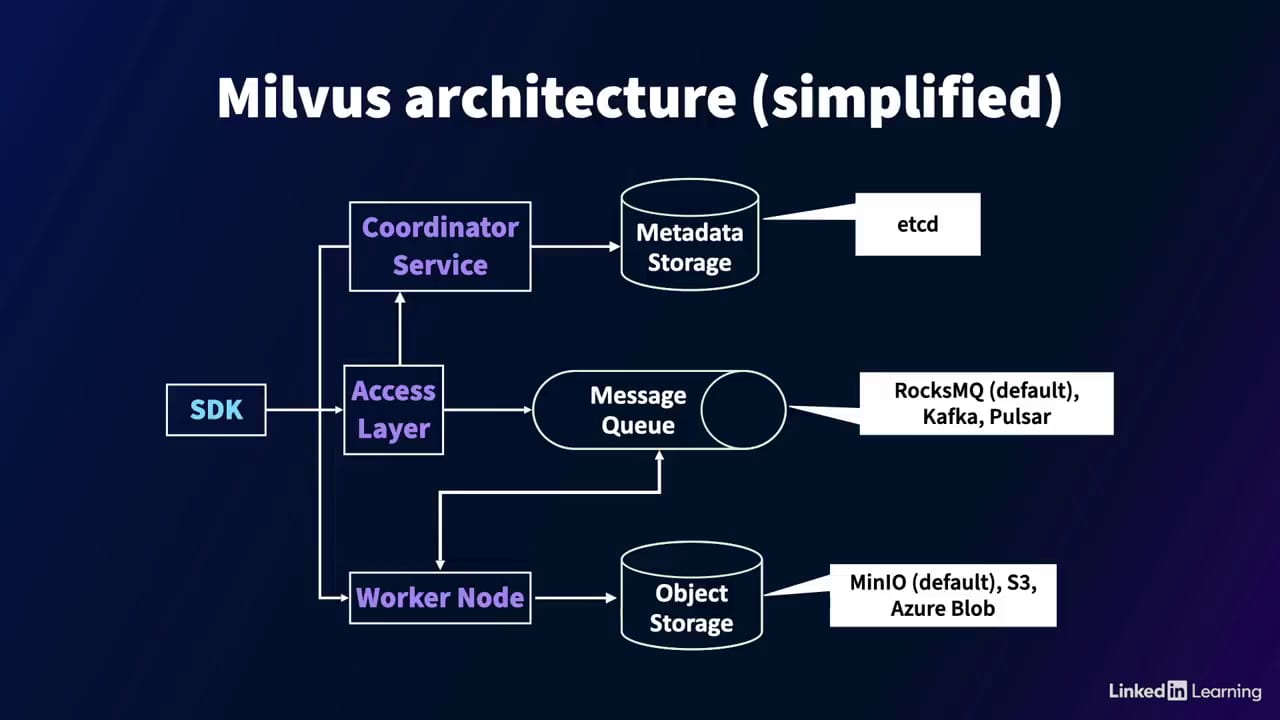
در ادامه با روش مدیریت داده ها، اجرای Query و انجام Search در Milvus آشنا می شوید. شناخت این قابلیت ها به شما کمک می کند نحوه تعامل با پایگاه داده را بهتر درک کنید و عملیات موردنیاز پروژه های خود را انجام دهید. همچنین مباحث مربوط به راه اندازی Milvus و آماده سازی محیط کار را بررسی می کنید تا بتوانید از ساختار این پایگاه داده برای ذخیره و بازیابی اطلاعات استفاده کنید.
کار با Milvus؛ از اتصال تا جستجوی داده های برداری
برای استفاده از Milvus در یک پروژه، ابتدا باید اتصال به پایگاه داده را برقرار کنید و ساختار موردنیاز را ایجاد نمایید. در این فرایند، ایجاد Database و User و سپس ساخت Collection از مراحل اولیه محسوب می شوند. پس از آماده سازی ساختار، می توانید داده های موردنظر را وارد پایگاه داده کنید. این مراحل پایه ای برای مدیریت اطلاعات و آماده سازی آن ها جهت جستجو و بازیابی هستند.
یکی دیگر از بخش های مهم کار با Milvus، ایجاد Index و اجرای عملیات جستجو است. در این آموزش با نحوه Query روی داده های Scalar و جستجو در فیلدهای Vector آشنا می شوید. همچنین روش حذف Objectها و Entityها را بررسی می کنید. این عملیات به شما کمک می کنند مدیریت داده ها را در سناریوهای مختلف بهتر انجام دهید و با قابلیت های اصلی Milvus در سطح عملی آشنا شوید.
استفاده از Vector Database برای Caching در مدل های زبانی بزرگ
مدل های زبانی بزرگ (LLM) برای پردازش درخواست ها به منابع محاسباتی نیاز دارند و اجرای مکرر درخواست های مشابه می تواند هزینه و زمان پردازش را افزایش دهد. Caching یکی از روش های مهم برای کاهش پردازش های تکراری است. در این رویکرد، نتایج یا اطلاعات قابل استفاده مجدد ذخیره می شوند تا در صورت دریافت درخواست مشابه، بتوان از داده های ذخیره شده استفاده کرد. Vector Database این امکان را فراهم می کند که درخواست ها بر اساس شباهت برداری نیز با یکدیگر مقایسه شوند.
در این آموزش با Workflow مربوط به Prompt Caching و نحوه راه اندازی Cache با استفاده از Milvus آشنا می شوید. همچنین بررسی می کنید که فرایند Inference چگونه با Caching ارتباط پیدا می کند و اطلاعات ذخیره شده چگونه در این جریان مورد استفاده قرار می گیرند. مدیریت Cache نیز اهمیت زیادی دارد؛ زیرا برای استفاده مؤثر از داده های ذخیره شده باید بتوان آن ها را سازمان دهی و کنترل کرد.
تولید تقویت شده با بازیابی (RAG) چیست؟
Retrieval Augmented Generation یا RAG روشی برای ترکیب قابلیت های تولید متن در LLMها با بازیابی اطلاعات از منابع دانش خارجی است. مدل های زبانی بزرگ دانش خود را از داده هایی به دست می آورند که با آن ها آموزش دیده اند، اما همیشه به اطلاعات اختصاصی یا به روز موردنیاز یک پروژه دسترسی ندارند. RAG این محدودیت را تا حدی برطرف می کند؛ به این صورت که پیش از تولید پاسخ، اطلاعات مرتبط از یک Knowledge Base بازیابی شده و در اختیار مدل قرار می گیرد.
فرایند RAG معمولاً شامل آماده سازی و سازمان دهی منابع دانش، بازیابی اطلاعات مرتبط و استفاده از آن ها برای پاسخ گویی به پرسش کاربران است. در این آموزش با فرایند Knowledge Curation و مراحل Question Answering در معماری RAG آشنا می شوید. همچنین کاربردهای این روش را بررسی می کنید و یاد می گیرید چگونه می توان از منابع اطلاعاتی اختصاصی برای ارائه پاسخ های مرتبط تر و متناسب با نیاز کاربران استفاده کرد.
پیاده سازی RAG با استفاده از Milvus
برای پیاده سازی RAG به یک منبع دانش و سازوکاری برای ذخیره و بازیابی اطلاعات مرتبط نیاز دارید. Vector Database می تواند این نقش را بر عهده بگیرد و امکان جستجوی معنایی در میان داده های ذخیره شده را فراهم کند. در این معماری، اطلاعات ابتدا آماده سازی می شوند و سپس به شکل Vector در پایگاه داده قرار می گیرند. هنگام دریافت پرسش کاربر نیز اطلاعات مرتبط بازیابی شده و به عنوان بخشی از ورودی در اختیار LLM قرار می گیرند.
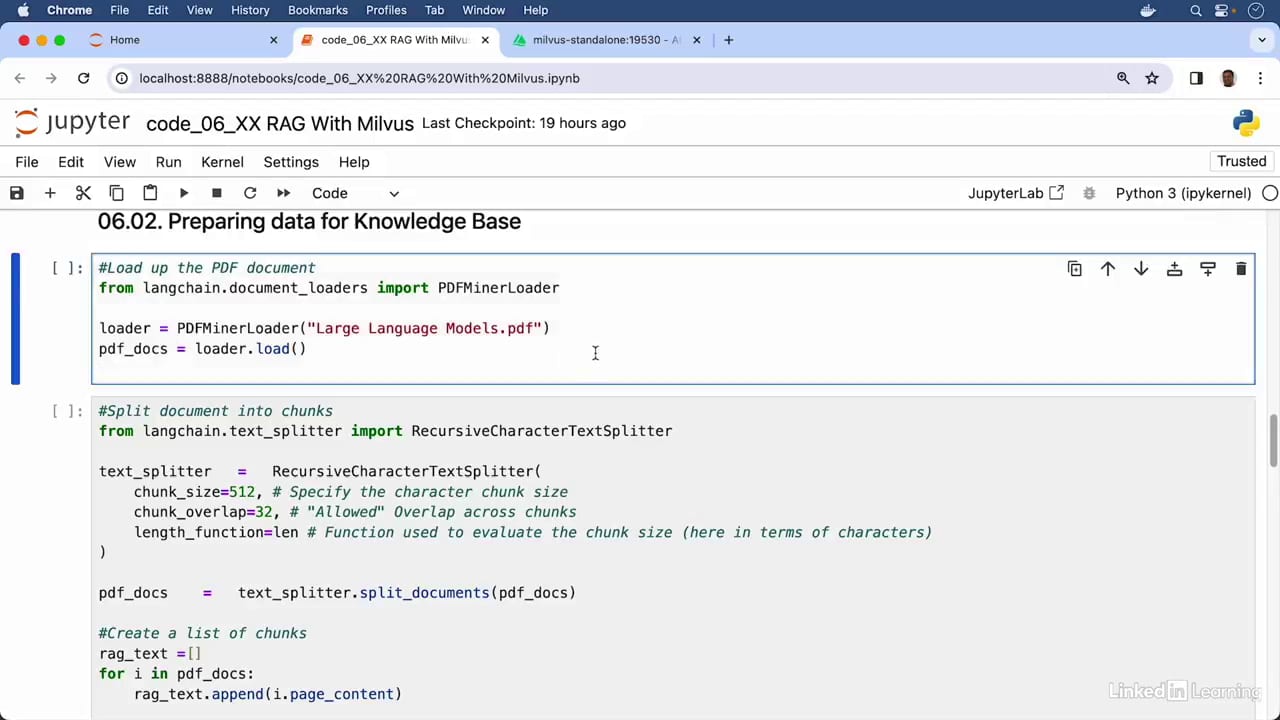
در این بخش با نحوه آماده سازی Milvus برای استفاده در معماری RAG آشنا می شوید. همچنین فرایند آماده سازی داده ها برای Knowledge Base و وارد کردن آن ها به پایگاه داده را بررسی می کنید. پس از آماده سازی اطلاعات، می توانید از RAG برای پاسخ گویی به پرسش ها استفاده کنید. این فرایند نشان می دهد چگونه می توان Milvus را در کنار LLMها به کار گرفت تا پاسخ ها بر اساس اطلاعات بازیابی شده تولید شوند.
بهترین روش ها برای انتخاب و بهینه سازی Vector Database
انتخاب Vector Database مناسب یکی از تصمیم های مهم در طراحی سیستم های مبتنی بر هوش مصنوعی است. پایگاه داده انتخاب شده باید با نوع داده ها، الگوی جستجو و نیازهای پروژه سازگار باشد. در برخی سناریوها، تنها داده های برداری کافی نیستند و لازم است اطلاعات Scalar نیز در کنار آن ها ذخیره و مدیریت شوند. ترکیب این دو نوع داده می تواند امکان فیلتر کردن و جستجوی دقیق تر را در سیستم فراهم کند.
معیار انتخاب روش اندازه گیری فاصله یا Distance Measure نیز بر نتایج جستجوی برداری تأثیر می گذارد. به همین دلیل باید با توجه به نوع Vectorها و کاربرد موردنظر، معیار مناسبی انتخاب شود. علاوه بر این، تنظیم و بهینه سازی عملکرد Vector Database اهمیت زیادی دارد؛ زیرا ساختار Indexها، نحوه ذخیره سازی و تنظیمات جستجو می توانند بر سرعت و کارایی سیستم تأثیر بگذارند. این مباحث به شما کمک می کنند تصمیم های فنی مناسب تری برای استفاده از Vector Database در پروژه های LLM بگیرید.
این آموزش برای توسعه دهندگانی مناسب است که می خواهند با زیرساخت های موردنیاز برای ساخت اپلیکیشن های مبتنی بر LLM آشنا شوند. اگر قصد دارید از Vector Database برای جستجوی معنایی، Caching یا پیاده سازی RAG استفاده کنید، یادگیری Milvus و مفاهیم مطرح شده در این آموزش می تواند نقطه شروع مناسبی باشد. همچنین آشنایی با این مباحث برای مهندسان نرم افزار و افرادی که در زمینه توسعه سیستم های هوش مصنوعی فعالیت می کنند مفید است.
سرفصل مطالب آموزش ویدئویی پایگاه داده های برداری برای Caching و تولید تقویت شده با بازیابی (RAG)
فصل اول: مقدمه
- هوش مصنوعی مولد با استفاده از پایگاه داده های برداری
- سرفصل های آموزش و پیش نیازها
فصل دوم: آشنایی با پایگاه داده های برداری
- Vector چیست؟
- تبدیل داده ها به بردار در NLP
- جستجوی شباهت برداری
- پایگاه داده های برداری
- مزایا و معایب پایگاه داده های برداری
فصل سوم: مفاهیم پایگاه داده Milvus
- آشنایی با پایگاه داده Milvus
- معماری Milvus
- Collectionها در Milvus
- Partitionها در Milvus
- Indexها در Milvus
- مدیریت داده ها در Milvus
- اجرای Query و جستجو در Milvus
- راه اندازی Milvus و فایل های تمرین
فصل چهارم: عملیات پایگاه داده Milvus
- ایجاد اتصال
- ایجاد Database و User
- ایجاد Collection
- درج داده در Milvus
- ساخت Index
- اجرای Query روی داده های Scalar
- جستجو در فیلدهای Vector
- حذف Objectها و Entityها
فصل پنجم: استفاده از Vector Database برای Caching درخواست های LLM
- مدل های زبانی بزرگ و Caching
- گردش کار Prompt Caching
- راه اندازی Cache در Milvus
- فرایند Inference و Caching
- مدیریت Cache
فصل ششم: مقدمه ای بر تولید تقویت شده با بازیابی (RAG)
- مدل های زبانی بزرگ به عنوان منبع دانش
- آشنایی با Retrieval Augmented Generation
- فرایند گردآوری و سازمان دهی دانش در RAG
- فرایند پرسش و پاسخ در RAG
- کاربردهای RAG
فصل هفتم: پیاده سازی RAG با Milvus
- راه اندازی Milvus برای RAG
- آماده سازی داده ها برای پایگاه دانش
- وارد کردن داده ها به پایگاه داده Milvus
- پاسخ گویی به پرسش ها با RAG
فصل هشتم: بهترین روش ها برای کار با پایگاه داده های برداری
- انتخاب پایگاه داده برداری
- ترکیب داده های Vector و Scalar
- نکات مربوط به معیار اندازه گیری فاصله
- تنظیم و بهینه سازی عملکرد Vector Database
فصل نهم: جمع بندی
- ادامه مسیر یادگیری با LLMها
محصولات مرتبط