آموزش بهینه سازی مدل های یادگیری عمیق با پایتون
آموزش بهینه سازی مدل های یادگیری عمیق با پایتون با عنوان اصلی Deep Learning with Python Optimizing Deep Learning Models یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. این دوره بر روشهای بهینهسازی مدلهای Deep Learning تمرکز دارد و به شما کمک میکند با تکنیکهای کاهش بیشبرازش، توابع خطا و الگوریتمهای بهینهسازی آشنا شوید. همچنین تنظیم Hyperparameterها، استفاده از KerasTuner و تکنیکهای پیشرفته آموزش مانند Batch Normalization، Gradient Clipping و Early Stopping را یاد میگیرید.
چرا بهینهسازی مدلهای Deep Learning اهمیت دارد؟
ساخت یک شبکه عصبی تنها اولین قدم در توسعه یک مدل یادگیری عمیق است. برای رسیدن به عملکرد مناسب، باید روش آموزش، پیچیدگی مدل و تنظیمات آن را نیز بررسی و بهینهسازی کرد. یک مدل ممکن است روی دادههای آموزشی عملکرد خوبی داشته باشد، اما هنگام مواجهه با دادههای جدید نتایج ضعیفتری ارائه دهد. بهینهسازی به توسعهدهندگان کمک میکند چنین مشکلاتی را شناسایی کنند و با انتخاب روشهای مناسب، توانایی مدل در یادگیری الگوهای قابل تعمیم را بهبود دهند.
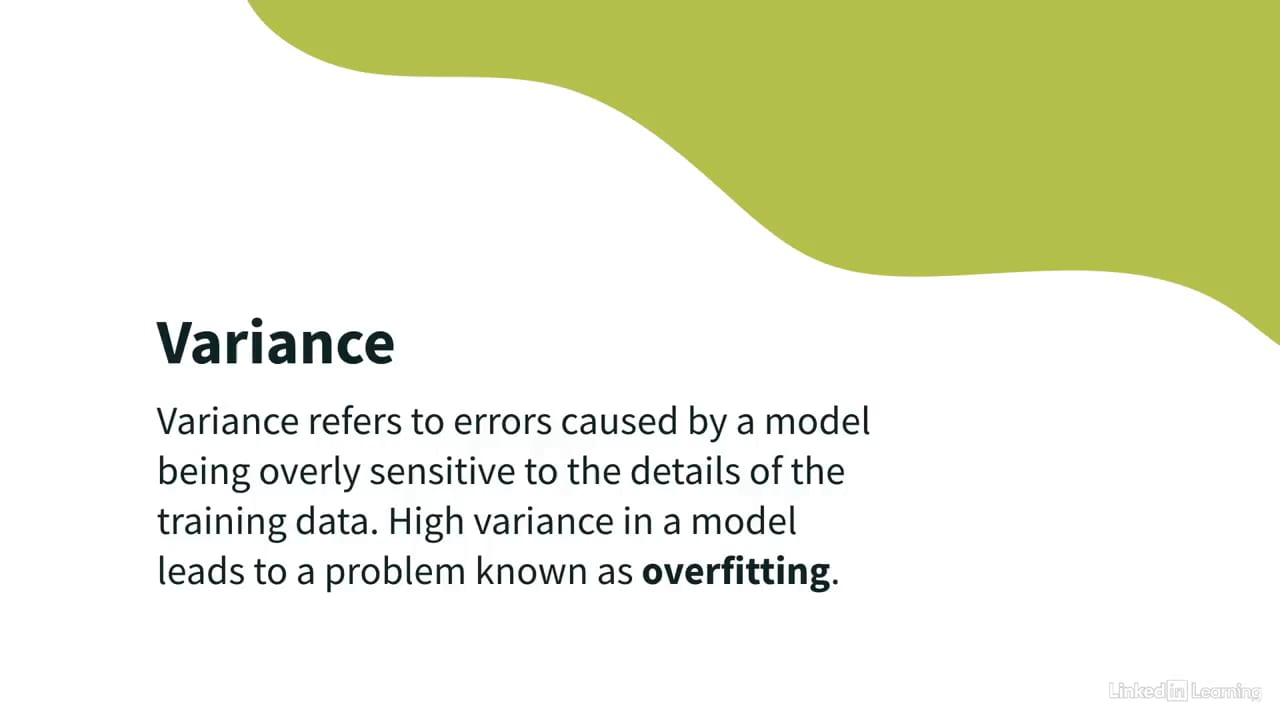
یکی از مفاهیم مهم در این زمینه، تعادل میان Bias و Variance است. مدلهایی که بیش از حد ساده هستند ممکن است الگوهای مهم داده را یاد نگیرند، در حالی که مدلهای بیش از حد پیچیده ممکن است به جزئیات و نویز دادههای آموزشی وابسته شوند. درک این تعادل به شما کمک میکند تصمیمهای آگاهانهتری درباره پیچیدگی مدل و روشهای کنترل آن بگیرید. در این آموزش، اهمیت بهینهسازی مدلهای Deep Learning بهعنوان نقطه شروع برای بررسی تکنیکهای تخصصیتر مطرح میشود.
تکنیکهای Regularization برای کاهش بیشبرازش
Regularization مجموعهای از روشهاست که برای کنترل پیچیدگی مدل و کاهش احتمال بیشبرازش یا Overfitting استفاده میشود. در این دوره، روشهای L1 و L2 بررسی میشوند که با افزودن جریمه به تابع هدف، بر نحوه یادگیری وزنهای شبکه تأثیر میگذارند. L1 میتواند به کوچک شدن برخی وزنها تا مقدار صفر کمک کند، در حالی که L2 وزنهای بزرگ را بیشتر جریمه میکند. شناخت تفاوت این روشها به شما کمک میکند هنگام طراحی مدل، تکنیک متناسب با مسئله خود را انتخاب کنید.
روش Elastic Net ترکیبی از ایدههای L1 و L2 است و Dropout رویکرد متفاوتی برای کنترل بیشبرازش ارائه میدهد. در Dropout، بخشی از واحدهای شبکه در مرحله آموزش بهصورت تصادفی غیرفعال میشوند تا مدل به مجموعه محدودی از مسیرهای یادگیری وابسته نماند. انتخاب و پیادهسازی صحیح این روشها میتواند بر توانایی مدل در تعمیم به دادههای جدید اثر بگذارد. این بخش علاوه بر توضیح مفاهیم، نحوه اعمال Regularizationهای مختلف در یک مدل Deep Learning را بررسی میکند.
توابع Loss و الگوریتمهای Optimization در یادگیری عمیق
تابع Loss میزان اختلاف میان خروجی پیشبینیشده مدل و مقدار مورد انتظار را اندازهگیری میکند و نقش مهمی در فرایند آموزش دارد. انتخاب تابع مناسب به نوع مسئله، مانند طبقهبندی یا رگرسیون، بستگی دارد. الگوریتم بهینهسازی نیز از اطلاعات مربوط به خطا و گرادیانها برای بهروزرسانی وزنهای شبکه استفاده میکند. بنابراین، حتی اگر معماری مدل مناسب باشد، انتخاب نامتناسب تابع Loss یا روش Optimization میتواند فرایند یادگیری را دشوارتر کند و بر کیفیت نتایج تأثیر بگذارد.
در این آموزش با روشهای Batch Gradient Descent، Stochastic Gradient Descent و Mini-batch Gradient Descent آشنا میشوید که از نظر نحوه استفاده از دادهها برای بهروزرسانی پارامترها تفاوت دارند. سپس الگوریتمهای تطبیقی AdaGrad، RMSProp، AdaDelta و Adam بررسی میشوند. این الگوریتمها شیوههای متفاوتی برای تنظیم بهروزرسانی وزنها و نرخ یادگیری مؤثر ارائه میکنند. شناخت مزایا و ویژگیهای هر روش به شما کمک میکند هنگام آموزش شبکههای عصبی، انتخاب مناسبتری داشته باشید و رفتار مدل را بهتر تحلیل کنید.
تنظیم Hyperparameterها با Keras و KerasTuner
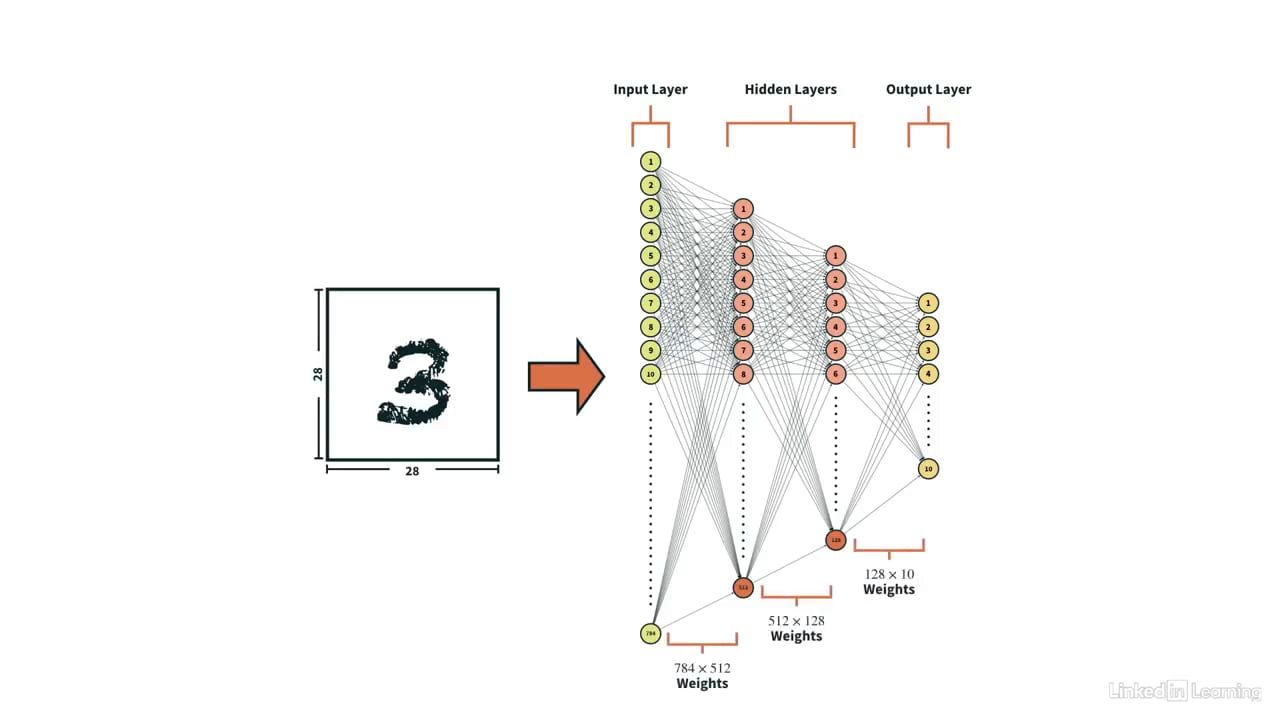
در مدلهای Deep Learning باید میان Parameterها و Hyperparameterها تفاوت قائل شد. Parameterهایی مانند وزنها و Biasها در طول آموزش از دادهها یاد گرفته میشوند، اما Hyperparameterها معمولاً پیش از آموزش یا در جریان فرایند تنظیم مدل تعیین میشوند. مواردی مانند Learning Rate، اندازه Batch، تعداد لایهها و تعداد واحدهای شبکه میتوانند بر سرعت یادگیری و عملکرد نهایی اثر بگذارند. انتخاب این مقادیر اغلب به آزمایش و مقایسه نیاز دارد، زیرا بهترین تنظیمات برای همه مدلها و مجموعهدادهها یکسان نیستند.
تنظیم Hyperparameter یا Hyperparameter Tuning فرایندی برای یافتن ترکیب مناسبی از تنظیمات مدل است. در این بخش، روشهای مختلف تنظیم این مقادیر و نحوه تعریف یک مدل قابل تنظیم با Keras معرفی میشوند. همچنین KerasTuner برای سازماندهی و اجرای آزمایشهای مربوط به Hyperparameterها مورد استفاده قرار میگیرد. به کمک این ابزار میتوان گزینههای مختلف را بهشکل ساختاریافته ارزیابی کرد و عملکرد آنها را با معیارهای مشخص مقایسه نمود. این مهارت برای توسعه مدلهایی که به تنظیمات دقیقتری نیاز دارند، کاربردی است.
تکنیکهای پیشرفته برای بهبود فرایند آموزش مدل
در کنار انتخاب معماری و الگوریتم بهینهسازی، نحوه مدیریت فرایند آموزش نیز اهمیت زیادی دارد. Batch Normalization با نرمالسازی مقادیر ورودی لایهها در طول آموزش، میتواند به پایداری و کارایی فرایند یادگیری کمک کند. Gradient Clipping نیز بزرگی گرادیانها را محدود میکند و در شرایطی که گرادیانها بیش از حد بزرگ میشوند، میتواند به کنترل ناپایداری آموزش کمک کند. آشنایی با این تکنیکها به شما امکان میدهد رفتار شبکه را بهتر مدیریت کنید و برای مشکلات رایج آموزش، راهکارهای مناسبی در اختیار داشته باشید.
روشهای Early Stopping و Checkpointing نیز برای مدیریت روند آموزش به کار میروند. Early Stopping میتواند آموزش را هنگامی متوقف کند که معیار موردنظر دیگر بهبود پیدا نمیکند، در حالی که Checkpointing امکان ذخیره وضعیت مدل در نقاط مشخص را فراهم میکند. علاوه بر این، Learning Rate Scheduling نرخ یادگیری را در طول آموزش بر اساس یک برنامه یا معیار مشخص تغییر میدهد. در این دوره، نحوه استفاده از این تکنیکها و بهکارگیری Callbacks برای مدیریت مراحل آموزش بررسی میشود تا بتوانید فرایند آموزش مدل را با کنترل بیشتری اجرا کنید.
این آموزش برای چه کسانی مناسب است؟
این دوره برای برنامهنویسان Python و افرادی مناسب است که با مبانی یادگیری عمیق آشنایی دارند و میخواهند کیفیت فرایند آموزش مدلهای خود را بهبود دهند. اگر پیشتر یک شبکه عصبی ساختهاید و اکنون میخواهید با Regularization، الگوریتمهای Optimization و تنظیم Hyperparameterها آشنا شوید، مباحث دوره میتوانند دانش شما را در این زمینه گسترش دهند. آشنایی اولیه با شبکههای عصبی، مفاهیم پایه Machine Learning و Python به درک بهتر مثالها و تکنیکهای مطرحشده کمک میکند.
مطالب دوره همچنین برای توسعهدهندگانی مفید است که از Keras برای ساخت مدل استفاده میکنند و میخواهند روشهای منظمتری برای آزمایش تنظیمات و مدیریت آموزش به کار بگیرند. یادگیری KerasTuner، Batch Normalization، Gradient Clipping و Callbacks میتواند به شما کمک کند گزینههای مختلف را ارزیابی کنید و مشکلات احتمالی آموزش را بهتر بشناسید. این دوره به زبان انگلیسی و همراه با زیرنویس انگلیسی ارائه میشود و در پایان، مسیر ادامه یادگیری و بهینهسازی مدلهای Deep Learning را نیز مطرح میکند.
سرفصل مطالب آموزش ویدئویی بهینه سازی مدل های یادگیری عمیق با پایتون
فصل اول: مقدمه
- بهینهسازی مدلهای یادگیری عمیق
- آنچه باید بدانید
- استفاده از فایلهای تمرین
فصل دوم: بهینهسازی مدلهای یادگیری عمیق
- اهمیت بهینهسازی مدلهای یادگیری عمیق
فصل سوم: تکنیکهای Regularization
- موازنه میان Bias و Variance
- Regularization به روشهای Lasso و Ridge
- اعمال Regularization از نوع L1 به مدل یادگیری عمیق
- اعمال Regularization از نوع L2 به مدل یادگیری عمیق
- Regularization به روش Elastic Net
- Regularization به روش Dropout
- اعمال Regularization به روش Dropout به مدل یادگیری عمیق
فصل چهارم: توابع Loss و الگوریتمهای Optimization
- توابع رایج Loss در یادگیری عمیق
- Batch Gradient Descent
- Stochastic Gradient Descent (SGD)
- Mini-batch Gradient Descent
- الگوریتم Adaptive Gradient (AdaGrad)
- الگوریتم Root Mean Square Propagation (RMSProp)
- الگوریتم Adaptive Delta (AdaDelta)
- الگوریتم Adaptive Moment Estimation (Adam)
فصل پنجم: تکنیکهای تنظیم Hyperparameter
- تفاوت Parameterها و Hyperparameterها
- Hyperparameterهای کلیدی در یادگیری عمیق
- روشهای تنظیم Hyperparameter
- تعریف یک مدل یادگیری عمیق قابل تنظیم در Keras
- استفاده از KerasTuner برای تنظیم Hyperparameterها
فصل ششم: تکنیکهای پیشرفته آموزش
- Batch Normalization
- اعمال Batch Normalization به مدل یادگیری عمیق
- Gradient Clipping
- اعمال Gradient Clipping به مدل یادگیری عمیق
- توقف زودهنگام (Early Stopping) و ذخیره Checkpoint
- زمانبندی نرخ یادگیری (Learning Rate Scheduling)
- آموزش مدل یادگیری عمیق با استفاده از Callbacks
فصل هفتم: جمع بندی
- ادامه بهینهسازی مدلهای یادگیری عمیق
محصولات مرتبط


دیدگاه ها