 پرووید
آموزش زیرساخت و عملیات هوش مصنوعی با فناوری های NVIDIA
آموزش زیرساخت و عملیات هوش مصنوعی با فناوری های NVIDIA با عنوان اصلی NVIDIA Certified Associate AI Infrastructure and Operations (NCA-AIIO) Cert Prep یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. در این دوره با مفاهیم بنیادی هوش مصنوعی، معماری مراکز داده مبتنی بر AI و فناوری های سخت افزاری و نرم افزاری NVIDIA آشنا می شوید. همچنین اجزای مختلف زیرساخت پردازشی، شبکه، ذخیره سازی و ابزارهای مدیریت GPU را بررسی می کنید. در ادامه، مباحث مربوط به AI Workflows، آموزش و اجرای مدل ها، Kubernetes، Slurm و MLOps را یاد می گیرید.
هوش مصنوعی چیست و چه کاربردی در صنایع مختلف دارد؟
هوش مصنوعی (AI) یکی از فناوری های مهم در توسعه نرم افزارهای مدرن است که امکان انجام وظایفی مانند تحلیل داده، تشخیص الگو، پردازش زبان طبیعی و تولید محتوا را فراهم می کند. امروزه سازمان های مختلف در صنایع گوناگون از AI برای بهبود فرایندها، خودکارسازی فعالیت ها و توسعه محصولات هوشمند استفاده می کنند. شناخت کاربردهای هوش مصنوعی و دلایل رشد سریع آن، نقطه شروع مناسبی برای ورود به دنیای زیرساخت های AI است.
در این دوره با تفاوت میان مفاهیم AI، Machine Learning (ML)، Deep Learning (DL) و Generative AI آشنا می شوید. همچنین با استفاده از مثال ها و تشبیه های ساده، ارتباط میان این حوزه ها را بهتر درک می کنید. در ادامه، مدل Transformer نیز معرفی می شود؛ معماری مهمی که نقش اساسی در توسعه بسیاری از مدل های زبانی و سیستم های هوش مصنوعی امروزی دارد.
زیرساخت مرکز داده هوش مصنوعی (AI Data Center) چیست؟
اجرای مدل های پیشرفته هوش مصنوعی به منابع محاسباتی، شبکه ای و ذخیره سازی قدرتمندی نیاز دارد. مرکز داده متمرکز بر AI به گونه ای طراحی می شود که بتواند حجم بالایی از محاسبات و انتقال داده را مدیریت کند. در چنین زیرساختی، عواملی مانند مصرف انرژی، توان پردازشی، ارتباط میان سرورها و سرعت دسترسی به داده ها تأثیر مستقیمی بر عملکرد سیستم دارند.
در این آموزش با مفهوم Power Usage Effectiveness (PUE) و نحوه ارزیابی بهره وری مصرف انرژی آشنا می شوید. همچنین تفاوت معماری CPU و GPU، نقش Data Processing Unit (DPU)، ساختار شبکه و Network Fabric بررسی می شود. موضوعاتی مانند تفاوت Ethernet و InfiniBand، فناوری Converged Ethernet و مقایسه زیرساخت Cloud با On-Prem نیز به شما کمک می کنند اجزای اصلی یک مرکز داده هوش مصنوعی را بهتر بشناسید.
فناوری های NVIDIA برای زیرساخت هوش مصنوعی
NVIDIA یکی از شرکت های پیشرو در توسعه سخت افزار و نرم افزارهای مورد استفاده در پردازش های سنگین هوش مصنوعی است. فناوری های این شرکت تنها به GPU محدود نمی شوند و مجموعه ای از راهکارهای پردازشی، ارتباطی، مدیریتی و نرم افزاری را در بر می گیرند. شناخت این فناوری ها برای مهندسان زیرساخت و توسعه دهندگانی که با سیستم های AI در مقیاس سازمانی کار می کنند اهمیت زیادی دارد.
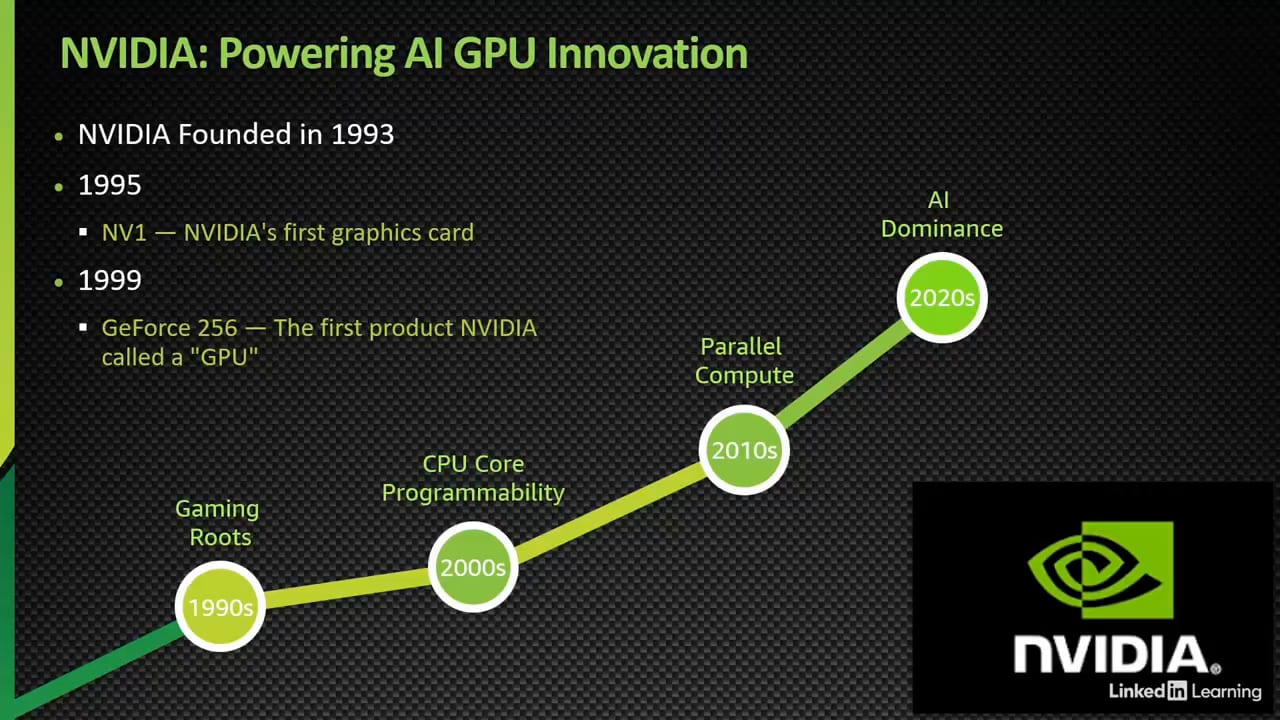
در این دوره با Technology Stack شرکت NVIDIA و اجزای مختلف آن آشنا می شوید. پلتفرم های DGX و DGX SuperPOD، کارت های گرافیکی، ConnectX، BlueField DPU و Reference Architectureها از جمله موضوعات مورد بررسی هستند. همچنین معماری GPU Coreها، نسل های مختلف DGX، تفاوت DGX A100 و H100 و گزینه های مختلف استقرار این زیرساخت ها معرفی می شوند تا دید جامع تری نسبت به پلتفرم های پردازشی NVIDIA به دست آورید.
ارتباطات پرسرعت و انتقال داده در زیرساخت NVIDIA
در زیرساخت های هوش مصنوعی، سرعت انتقال داده میان GPUها و سایر اجزای سیستم به اندازه توان پردازشی اهمیت دارد. فناوری هایی مانند NVLink و InfiniBand برای ایجاد ارتباطات سریع و کاهش محدودیت های انتقال داده در محیط های محاسباتی پیشرفته استفاده می شوند. همچنین تکنیک هایی مانند DMA و RDMA امکان انتقال داده را با دخالت کمتر CPU فراهم می کنند و در بهینه سازی ارتباط میان اجزای زیرساخت نقش دارند.
در این آموزش با فناوری های Data Movement و I/O Acceleration در اکوسیستم NVIDIA آشنا می شوید. تفاوت InfiniBand و Ethernet، مفهوم GPUDirect RDMA و فناوری GPUDirect Storage از جمله مباحث این بخش هستند. همچنین ارتباط میان NVLink، NVSwitch، PCIe و RDMA بررسی می شود تا بتوانید نقش هر فناوری را در انتقال داده و ارتباط میان پردازنده ها و تجهیزات ذخیره سازی بهتر درک کنید.
مدیریت GPU، CUDA و ابزارهای مانیتورینگ NVIDIA
برای استفاده مؤثر از GPU در محیط های عملیاتی، تنها در اختیار داشتن سخت افزار قدرتمند کافی نیست. سیستم عامل، Driverها، مجازی سازی و کتابخانه های پردازشی باید به درستی پیکربندی شوند. NVIDIA برای مدیریت این بخش ها مجموعه ای از ابزارها و فناوری ها ارائه می دهد که امکان استفاده بهینه از منابع GPU را در محیط های مختلف فراهم می کنند.
در این دوره با GPU Drivers، GPU Virtualization و تفاوت فناوری های vGPU و MIG آشنا می شوید. سپس کتابخانه های اصلی مانند CUDA و NCCL و نحوه نصب CUDA بررسی می شوند. در بخش مدیریت و مانیتورینگ نیز ابزارهایی مانند NVIDIA-SMI، Data Center GPU Manager (DCGM) و Base Command Manager معرفی می شوند. همچنین با NVIDIA AI Enterprise و NVIDIA AI Factory به عنوان بخشی از راهکارهای نرم افزاری و زیرساختی NVIDIA آشنا خواهید شد.
AI Workflows و مدیریت چرخه عمر مدل های هوش مصنوعی
توسعه و اجرای مدل های هوش مصنوعی شامل مراحل مختلفی از آماده سازی داده و آموزش مدل تا اجرای مدل و مدیریت منابع پردازشی است. این مراحل در قالب AI Workflow سازمان دهی می شوند و برای اجرای مؤثر آن ها به Frameworkها و ابزارهای مناسب نیاز است. انتخاب ابزارهای درست برای مدیریت پردازش ها و هماهنگ سازی منابع، به ویژه در محیط های چند GPU و زیرساخت های توزیع شده، اهمیت زیادی دارد.
در این بخش با ML Frameworkها، تفاوت Model Training و Model Inference و نقش فناوری های NVIDIA در بهینه سازی فرایندهای یادگیری ماشین آشنا می شوید. همچنین تفاوت Job Scheduling و Container Orchestration و مقایسه Slurm با Kubernetes بررسی می شود. در ادامه، مفهوم MLOps و دلایل اهمیت آن در مدیریت چرخه عمر مدل های یادگیری ماشین معرفی شده و ابزارهای NVIDIA برای پشتیبانی از فرایندهای MLOps مورد بررسی قرار می گیرند.
این آموزش برای چه کسانی مناسب است؟
این دوره برای مهندسان زیرساخت، مدیران سیستم، متخصصان Cloud و Data Center، مهندسان هوش مصنوعی و افرادی مناسب است که می خواهند دانش خود را در زمینه طراحی و مدیریت زیرساخت های مورد نیاز برای AI توسعه دهند. اگر با مفاهیم شبکه، سیستم عامل، پردازش موازی یا زیرساخت های نرم افزاری آشنایی دارید و قصد دارید وارد حوزه AI Infrastructure and Operations شوید، موضوعات این دوره می توانند دید جامعی از این حوزه در اختیار شما قرار دهند.
همچنین توسعه دهندگانی که با Machine Learning کار می کنند و می خواهند ارتباط میان مدل های هوش مصنوعی، GPU، شبکه، ذخیره سازی و ابزارهای عملیاتی را بهتر درک کنند، می توانند از این آموزش بهره ببرند. محتوای دوره به زبان انگلیسی ارائه شده و دارای زیرنویس انگلیسی است.
سرفصل مطالب آموزش ویدئویی زیرساخت و عملیات هوش مصنوعی با فناوری های NVIDIA
فصل اول: مقدمه
- مقدمه
فصل دوم: جزئیات گواهینامه
- گواهینامههای NVIDIA
- موضوعات تحت پوشش گواهینامه
فصل سوم: ماژول اول — مبانی
- عوامل محرک تکامل هوش مصنوعی
- موارد استفاده از هوش مصنوعی در صنایع مختلف
- هوش مصنوعی (AI)، یادگیری ماشین (ML)، یادگیری عمیق (DL) و هوش مصنوعی مولد (Gen AI)
- تشبیهی برای درک AI، ML، DL و Gen AI
- مدل Transformer
فصل چهارم: ماژول دوم — آشنایی با اجزای داخلی مرکز داده مبتنی بر هوش مصنوعی
- آشنایی با ساختار داخلی مرکز داده مبتنی بر هوش مصنوعی
- شاخص بهرهوری مصرف انرژی (PUE)
- توان محاسباتی
- CPU و GPU
- تفاوتهای معماری CPU و GPU
- فراتر از قانون Moore
- واحد پردازش داده (DPU)
- شبکه در مرکز داده مبتنی بر هوش مصنوعی
- ساختار شبکه (Network Fabric)
- مقایسه Ethernet و InfiniBand
- Ethernet همگرا (CE)
- ذخیرهسازی در مرکز داده مبتنی بر هوش مصنوعی
- مقایسه Cloud و زیرساخت On-Prem
فصل پنجم: ماژول سوم — پشته فناوری NVIDIA
- نقش NVIDIA در پیشبرد نوآوری GPU برای هوش مصنوعی
- پشته فناوری NVIDIA
- لایه اول: لایه فیزیکی
- GPU روی کارت گرافیک
- پلتفرم DGX
- DGX SuperPOD
- ConnectX
- پردازندههای DPU سری BlueField
- معماریهای مرجع NVIDIA
- آشنایی با هستههای GPU
- مقایسه هستههای GPU
- سیر تکامل پلتفرم NVIDIA DGX
- گزینههای استقرار پلتفرم DGX
- مقایسه DGX A100 و H100
- لایه دوم: انتقال داده و شتابدهی I/O
- NVLink
- InfiniBand
- مقایسه InfiniBand و Ethernet
- DMA و RDMA
- GPUDirect RDMA
- GPUDirect Storage
- مقایسه سریع
- لایه سوم: سیستمعامل، Driver و مجازیسازی
- درایورهای GPU
- مجازیسازی GPU
- مقایسه vGPU و MIG، بخش اول
- مقایسه vGPU و MIG، بخش دوم
- لایه چهارم: کتابخانههای اصلی
- معماری Compute Unified Device Architecture (CUDA)
- نصب CUDA
- کتابخانه ارتباطات جمعی NVIDIA (NCCL)
- مقایسه NVLink، NVSwitch، PCIe و RDMA با NCCL
- لایه پنجم: مانیتورینگ و مدیریت
- NVIDIA-SMI
- ابزار مدیریت GPU در مرکز داده (DCGM)
- Base Command Manager
- از کدام ابزار استفاده کنیم؟
- لایه ششم: اپلیکیشنها و راهکارهای تخصصی حوزههای مختلف
- جمعبندی
- NVIDIA AI Enterprise
- NVIDIA AI Factory
فصل ششم: ماژول چهارم — گردشکارهای هوش مصنوعی
- گردشکارهای هوش مصنوعی
- فریمورکهای یادگیری ماشین (ML)
- مزیت رقابتی فناوریهای NVIDIA
- مقایسه آموزش مدل (Model Training) و استنتاج مدل (Model Inference)
- مقایسه زمانبندی وظایف (Job Scheduling) و ارکستراسیون کانتینرها (Container Orchestration)
- مقایسه Slurm و Kubernetes
- یکپارچهسازی فناوریهای NVIDIA
- تشبیهی برای درک MLOps
- چرا به MLOps نیاز داریم؟
- ابزارهای NVIDIA برای پشتیبانی از MLOps
محصولات مرتبط