 پرووید
آموزش خوشه بندی K-Means در یادگیری ماشین با Python
آموزش خوشه بندی K-Means در یادگیری ماشین با Python با عنوان اصلی Machine Learning with Python k-Means Clustering یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. در این دوره با مفاهیم خوشه بندی و الگوریتم K-Means آشنا می شوید و یاد می گیرید چگونه از این الگوریتم برای دسته بندی داده ها با استفاده از Python استفاده کنید. همچنین روش انتخاب تعداد مناسب خوشه ها، ارزیابی نتایج و نمایش بصری خوشه ها را فرا خواهید گرفت.
خوشه بندی (Clustering) چیست؟
خوشه بندی یکی از روش های یادگیری ماشین بدون نظارت (Unsupervised Learning) است که برای تقسیم داده ها به گروه های مختلف بر اساس شباهت میان آن ها استفاده می شود. در این روش، برخلاف یادگیری نظارت شده، داده ها از قبل برچسب گذاری نشده اند و الگوریتم تلاش می کند الگوها و شباهت های موجود در داده ها را شناسایی کند.
خوشه بندی در تحلیل داده ها، شناسایی الگوهای رفتاری و بخش بندی مشتریان کاربرد دارد. با استفاده از این روش می توان مجموعه ای از داده ها را به گروه هایی تقسیم کرد که اعضای هر گروه ویژگی های مشابهی دارند. آشنایی با مفهوم Clustering اولین قدم برای درک الگوریتم K-Means و نحوه استفاده از آن در پروژه های یادگیری ماشین است.
الگوریتم K-Means چیست؟
K-Means یکی از الگوریتم های شناخته شده خوشه بندی در یادگیری ماشین است که داده ها را بر اساس شباهت ویژگی هایشان به تعداد مشخصی از خوشه ها تقسیم می کند. در این الگوریتم، هر خوشه یک مرکز دارد و داده ها بر اساس فاصله از این مراکز در گروه مناسب قرار می گیرند. هدف اصلی الگوریتم، ایجاد خوشه هایی است که داده های درون آن ها تا حد امکان به یکدیگر نزدیک باشند.
یکی از موضوعات مهم هنگام استفاده از K-Means، انتخاب تعداد مناسب خوشه ها است. تعداد خوشه ها تأثیر مستقیمی بر نتیجه خوشه بندی دارد و انتخاب مقدار نامناسب می تواند باعث ایجاد گروه هایی شود که به درستی ساختار داده ها را نشان نمی دهند. در این آموزش با نحوه انتخاب تعداد خوشه ها و شرایط مناسب استفاده از این الگوریتم آشنا می شوید.
کاربردهای خوشه بندی K-Means
الگوریتم K-Means در موقعیت هایی کاربرد دارد که بخواهیم بدون داشتن دسته بندی از پیش تعیین شده، داده های مشابه را در گروه های جداگانه قرار دهیم. برای مثال، در تحلیل رفتار مشتریان می توان افراد را بر اساس ویژگی ها و الگوهای خریدشان به گروه های مختلف تقسیم کرد. این دسته بندی به تحلیل بهتر داده ها و شناسایی الگوهای مشترک کمک می کند.
از دیگر کاربردهای این الگوریتم می توان به تحلیل مجموعه داده ها، شناسایی گروه های مشابه و بررسی ساختار پنهان اطلاعات اشاره کرد. K-Means به دلیل رویکرد مشخص و قابل درک خود، یکی از الگوریتم های مناسب برای آشنایی با روش های خوشه بندی است. درک کاربردهای آن به شما کمک می کند تشخیص دهید چه زمانی استفاده از این روش می تواند برای تحلیل داده ها مفید باشد.
پیاده سازی الگوریتم K-Means با Python
برای استفاده عملی از الگوریتم K-Means، آشنایی با Python و ابزارهای مورد نیاز برای کار با داده ها اهمیت دارد. در این آموزش ابتدا با پیش نیازهای دوره و ابزارهای لازم آشنا می شوید و سپس نحوه استفاده از K-Means برای بخش بندی داده ها را در محیط Python یاد می گیرید. همچنین با نحوه استفاده از فایل های تمرینی در روند یادگیری آشنا خواهید شد.
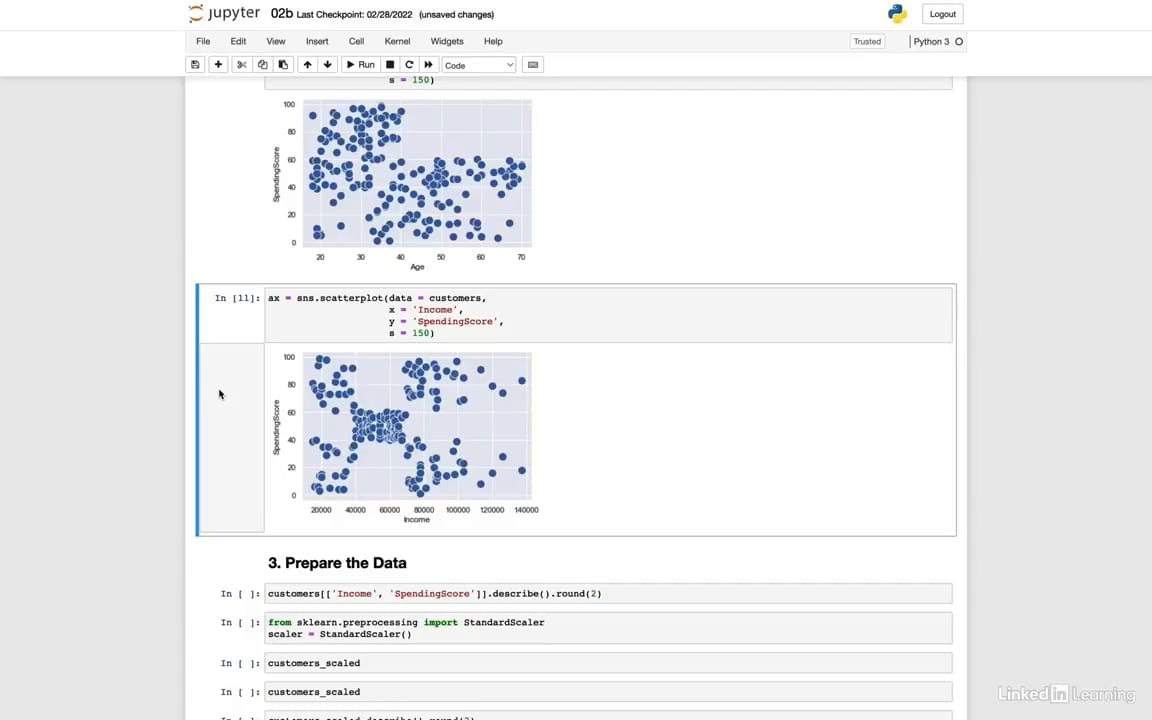
در مرحله پیاده سازی، یاد می گیرید چگونه یک مجموعه داده را با استفاده از K-Means به خوشه های مختلف تقسیم کنید. این فرایند شامل اجرای الگوریتم، انتخاب تعداد خوشه ها و بررسی نحوه قرارگیری داده ها در گروه های ایجادشده است. به این ترتیب می توانید مفاهیم نظری خوشه بندی را به مراحل عملی تحلیل داده با Python تبدیل کنید.
ارزیابی و نمایش بصری خوشه ها در Python
پس از اجرای الگوریتم K-Means، لازم است کیفیت خوشه های ایجادشده را بررسی کنید. صرفاً تقسیم داده ها به چند گروه به معنای رسیدن به نتیجه مناسب نیست. باید بتوانید بررسی کنید که داده های هر خوشه تا چه اندازه به یکدیگر شباهت دارند و آیا تعداد انتخاب شده برای خوشه ها با ساختار مجموعه داده تناسب دارد یا خیر.
در این دوره با روش ارزیابی و نمایش بصری خوشه ها در Python آشنا می شوید. همچنین یاد می گیرید چگونه تعداد مناسب خوشه ها را با استفاده از داده های خود پیدا کنید. نمایش بصری نتایج کمک می کند ارتباط میان گروه ها را بهتر بررسی کنید و درک روشن تری از خروجی الگوریتم داشته باشید.
تفسیر نتایج K-Means و مراحل بعدی یادگیری
یکی از بخش های مهم تحلیل داده، درک نتایج الگوریتم و تبدیل خروجی آن به اطلاعات قابل استفاده است. پس از اجرای K-Means باید بتوانید خوشه های ایجادشده را بررسی و ویژگی های هر گروه را تفسیر کنید. این کار به شما کمک می کند فقط به خروجی الگوریتم اکتفا نکنید و مفهوم واقعی دسته بندی انجام شده را بهتر درک کنید.
در بخش پایانی آموزش، با نحوه تفسیر نتایج خوشه بندی K-Means در Python و مسیرهای بعدی یادگیری آشنا می شوید. این مباحث دید مناسبی از مراحل اصلی کار با الگوریتم، از شناخت مفاهیم اولیه تا پیاده سازی، ارزیابی و تحلیل نتایج، در اختیار شما قرار می دهند.
سرفصل مطالب آموزش ویدئویی خوشه بندی K-Means در یادگیری ماشین با Python
فصل اول: مقدمه
- شروع کار با Python و خوشهبندی k-means
- پیشنیازهای دوره
- ابزارهای مورد نیاز
- نحوه استفاده از فایلهای تمرین
فصل دوم: آشنایی با خوشهبندی k-means
- خوشهبندی چیست؟
- خوشهبندی k-means چیست؟
- انتخاب تعداد مناسب خوشهها
- چرا و چه زمانی از خوشهبندی k-means استفاده کنیم؟
فصل سوم: بخشبندی دادهها با خوشهبندی k-means
- نحوه بخشبندی دادهها با خوشهبندی k-means در Python
- نحوه ارزیابی و بصریسازی خوشهها در Python
- نحوه یافتن تعداد مناسب خوشهها در Python
- نحوه تفسیر نتایج خوشهبندی k-means در Python
فصل چهارم: جمع بندی
- گامهای بعدی
محصولات مرتبط