 پرووید
آموزش یادگیری ماشین با Amazon SageMaker
آموزش یادگیری ماشین با Amazon SageMaker با عنوان اصلی Machine Learning with SageMaker by Pearson یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. در این دوره با مفاهیم و مراحل مختلف پیادهسازی راهکارهای یادگیری ماشین در بستر AWS و با استفاده از Amazon SageMaker آشنا می شوید. از آمادهسازی و پردازش دادهها و آموزش مدلهای یادگیری ماشین گرفته تا ارزیابی، استقرار، خودکارسازی و نظارت بر عملکرد مدلها، موضوعاتی هستند که در این آموزش به صورت عملی بررسی می شوند.
Amazon SageMaker چیست و چه کاربردی در یادگیری ماشین دارد؟
Amazon SageMaker یک سرویس مدیریتشده در AWS است که به توسعهدهندگان و متخصصان داده کمک میکند مدلهای یادگیری ماشین را در محیط ابری ایجاد، آموزش، ارزیابی و مستقر کنند. این سرویس ابزارهای مختلفی برای مدیریت دادهها، انتخاب الگوریتمها، اجرای فرایند آموزش و ارائه مدلها در اختیار کاربران قرار میدهد. با استفاده از SageMaker میتوان بخش زیادی از زیرساخت موردنیاز برای اجرای پروژههای Machine Learning را بدون مدیریت مستقیم سرورها فراهم کرد.
در این آموزش ابتدا با ساختار کلی یادگیری ماشین در SageMaker و نحوه ورود و ذخیرهسازی دادهها آشنا میشوید. فرمتهای رایج داده، استفاده از Amazon S3 و SageMaker Data Wrangler برای دریافت دادهها و همچنین روشهای بهینهسازی ذخیرهسازی و انتقال اطلاعات در AWS بررسی میشوند. این مباحث پایهای به شما کمک میکنند درک بهتری از جریان ورود داده به یک پروژه یادگیری ماشین داشته باشید و برای مراحل بعدی آماده شوید.
پردازش دادهها و Feature Engineering در Amazon SageMaker
کیفیت دادهها یکی از عوامل مهم در موفقیت مدلهای یادگیری ماشین است. دادههای خام معمولاً دارای مقادیر ناقص، اطلاعات نامعتبر یا دادههای پرت هستند و پیش از استفاده در فرایند آموزش باید آمادهسازی شوند. در این مرحله با قابلیتهای SageMaker Data Wrangler برای پاکسازی و پیشپردازش دادهها آشنا میشوید و یاد میگیرید چگونه دادهها را برای استفاده در مدلهای Machine Learning آماده کنید.
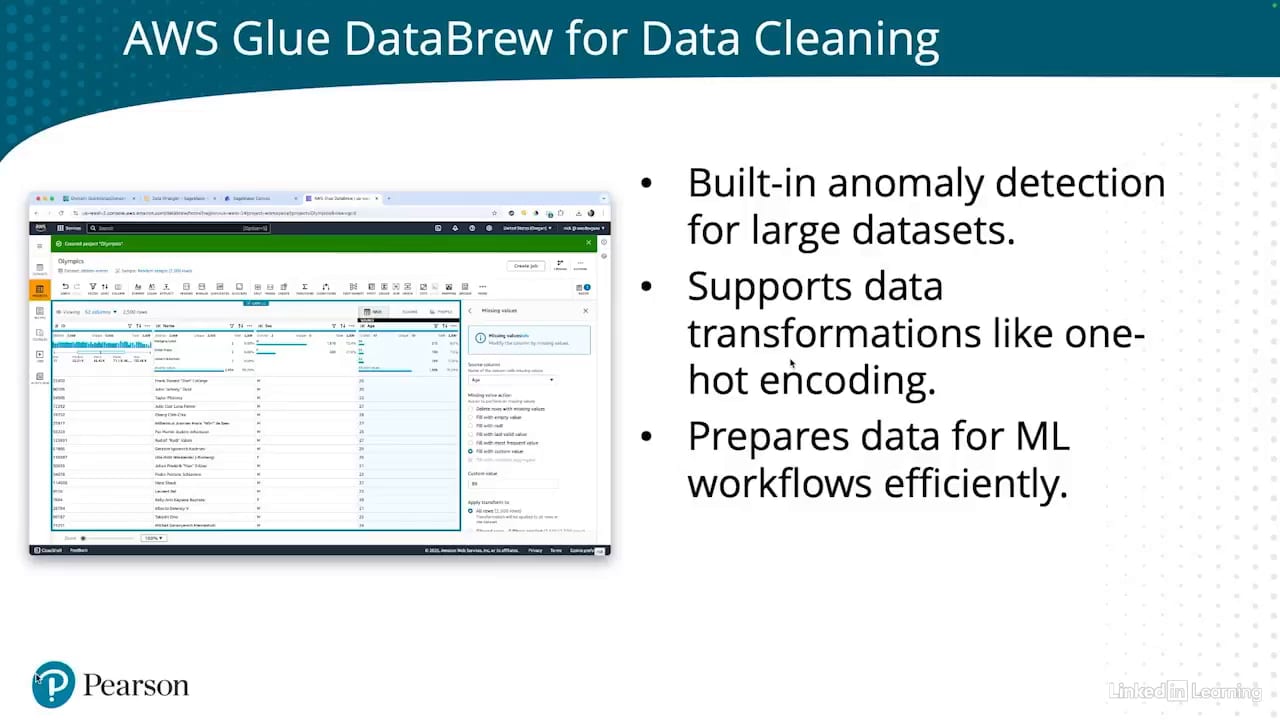
همچنین تکنیکهای Feature Engineering مانند Feature Scaling و Encoding بررسی میشوند. این تکنیکها به تبدیل ویژگیهای ورودی به ساختاری مناسب برای الگوریتمهای یادگیری ماشین کمک میکنند. مدیریت Missing Values و Outliers نیز از دیگر موضوعات این بخش است. در ادامه با اعتبارسنجی کیفیت دادهها، آمادهسازی اطلاعات برای SageMaker Training Jobs و مدیریت SageMaker Feature Store آشنا میشوید تا بتوانید ویژگیهای موردنیاز مدلها را به شکلی منظم مدیریت کنید.
آموزش و انتخاب مدلهای یادگیری ماشین با SageMaker
انتخاب الگوریتم مناسب و تنظیم صحیح فرایند آموزش، نقش مهمی در کیفیت مدل نهایی دارد. Amazon SageMaker مجموعهای از Built-in Algorithms و مدلهای آماده JumpStart را ارائه میدهد که میتوان از آنها برای پیادهسازی سناریوهای مختلف یادگیری ماشین استفاده کرد. در این آموزش با الگوریتمهای داخلی SageMaker و نحوه انتخاب مدل مناسب آشنا میشوید و یاد میگیرید چگونه Training Jobs را پیکربندی و اجرا کنید.
پس از آشنایی با فرایند آموزش، موضوع Hyperparameter Tuning و استفاده از قابلیت Automatic Model Tuning بررسی میشود. تنظیم Hyperparameterها میتواند به بهبود عملکرد مدل کمک کند. همچنین با مفاهیم Overfitting و Underfitting آشنا میشوید و یاد میگیرید چگونه این دو مشکل را در فرایند آموزش شناسایی و مدیریت کنید. این مباحث برای ساخت مدلهایی که بتوانند روی دادههای جدید نیز عملکرد مناسبی داشته باشند اهمیت زیادی دارند.
ارزیابی مدل و تشخیص Bias با Amazon SageMaker
پس از آموزش یک مدل، باید عملکرد آن را با معیارهای مناسب ارزیابی کنید. در این بخش با معیارهای Accuracy، Precision و Recall آشنا میشوید و یاد میگیرید چگونه از آنها برای بررسی کیفیت پیشبینیهای مدل استفاده کنید. انتخاب معیار مناسب به نوع مسئله و هدف پروژه بستگی دارد و میتواند دید دقیقتری درباره نقاط قوت و ضعف مدل در اختیار شما قرار دهد.
یکی دیگر از موضوعات مهم، شناسایی Bias و بررسی قابلیت تفسیر مدلها با استفاده از Amazon SageMaker Clarify است. همچنین مقایسه عملکرد مدلها از طریق A/B Testing و مدیریت نسخههای مختلف مدل با SageMaker Model Registry آموزش داده میشود. این قابلیتها به شما کمک میکنند تغییرات مدلها را کنترل کنید، عملکرد نسخههای مختلف را بسنجید و پیش از استفاده گسترده از یک مدل، نتایج آن را با دقت بیشتری بررسی کنید.
استقرار مدلهای Machine Learning در AWS
بعد از آموزش و ارزیابی مدل، نوبت به استقرار آن و استفاده از قابلیت پیشبینی میرسد. Amazon SageMaker روشهای مختلفی برای ارائه مدلها در اختیار شما قرار میدهد. در این بخش با Real-Time Inference و نحوه استفاده از SageMaker Endpoints آشنا میشوید. این روش زمانی کاربرد دارد که برنامهها نیاز داشته باشند در لحظه درخواستهای خود را به مدل ارسال کنند و پاسخ پیشبینی را دریافت کنند.
علاوه بر پیشبینی بلادرنگ، روشهای Batch Inference و Asynchronous Inference نیز بررسی میشوند که برای پردازش درخواستها و دادهها در شرایط مختلف مناسب هستند. در ادامه با Amazon SageMaker Neo آشنا میشوید که امکان بهینهسازی و استقرار مدلها روی دستگاههای Edge را فراهم میکند. شناخت این روشها به شما کمک میکند با توجه به نیاز پروژه، شیوه مناسب برای ارائه مدل یادگیری ماشین را انتخاب کنید.
خودکارسازی و نظارت بر گردش کارهای یادگیری ماشین
در پروژههای واقعی، اجرای دستی تمام مراحل یادگیری ماشین میتواند زمانبر و دشوار باشد. SageMaker Pipelines این امکان را فراهم میکند که مراحل مختلف یک فرایند Machine Learning را به صورت یک Workflow منظم تعریف و خودکارسازی کنید. در این آموزش با ساخت ML Pipeline در SageMaker و اتصال مراحل پردازش داده به مراحل آموزش مدل آشنا میشوید. به این ترتیب میتوانید بخشهای مختلف فرایند توسعه مدل را در قالب یک جریان کاری قابل مدیریت اجرا کنید.
همچنین نحوه فعالسازی Pipelineها با استفاده از Amazon EventBridge برای اجرای مجدد فرایند آموزش بررسی میشود. پس از خودکارسازی، نظارت بر کیفیت و عملکرد مدل اهمیت پیدا میکند. در این بخش با SageMaker Model Monitor برای شناسایی Data Drift و تغییر کیفیت دادهها آشنا میشوید. تنظیم Alertها و ساخت Dashboard با Amazon CloudWatch و همچنین بهینهسازی هزینهها با Auto Scaling و SageMaker Savings Plans از دیگر مباحث این قسمت هستند.
امنیت و مدیریت دسترسی در Amazon SageMaker
امنیت دادهها و مدلهای یادگیری ماشین یکی از موضوعات مهم هنگام استفاده از سرویسهای ابری است. در این بخش با نحوه مدیریت دسترسیها در Amazon SageMaker از طریق AWS Identity and Access Management یا IAM آشنا میشوید. با تعریف IAM Roles و تنظیم Permissions میتوانید مشخص کنید هر کاربر یا سرویس به چه منابعی دسترسی داشته باشد. این موضوع به مدیریت بهتر دسترسیها و کاهش ریسکهای امنیتی در محیطهای توسعه و عملیاتی کمک میکند.
در ادامه، تنظیمات Virtual Private Cloud یا VPC برای استقرار امن SageMaker Endpoints بررسی میشوند. با استفاده از تنظیمات شبکهای مناسب میتوان ارتباط میان منابع مختلف را کنترل کرد و محیط امنتری برای اجرای مدلها فراهم ساخت. در مجموع، این بخش به شما کمک میکند علاوه بر یادگیری مراحل ساخت و استقرار مدلهای Machine Learning، با ملاحظات امنیتی و مدیریت زیرساخت موردنیاز برای اجرای آنها در AWS نیز آشنا شوید.
سرفصل مطالب آموزش ویدئویی یادگیری ماشین با Amazon SageMaker
فصل اول: مقدمه
- مقدمه ای بر یادگیری ماشین با SageMaker
فصل دوم: مبانی دریافت و ذخیره سازی داده
- مقدمه ماژول
- اهداف یادگیری
- معرفی کلی دوره
- مروری بر فرمت های رایج داده
- دریافت داده با استفاده از Amazon S3 و SageMaker Data Wrangler
- نمایش عملی فرآیند دریافت داده
- بهینه سازی ذخیره سازی و انتقال داده در AWS
فصل سوم: تبدیل داده و مهندسی ویژگی با SageMaker
- اهداف یادگیری
- پاک سازی و پیش پردازش داده با SageMaker Data Wrangler
- نمایش عملی پیش پردازش داده
- تکنیک های مقیاس بندی و کدگذاری ویژگی ها
- مدیریت مقادیر گمشده و داده های پرت
فصل چهارم: آماده سازی داده برای مدل سازی
- اهداف یادگیری
- اعتبارسنجی کیفیت داده با ابزارهای AWS
- پیکربندی داده ها برای SageMaker Training Jobs
- مدیریت SageMaker Feature Store
- نمایش عملی SageMaker Feature Store
فصل پنجم: انتخاب و آموزش مدل ها در SageMaker
- مقدمه ماژول
- اهداف یادگیری
- مروری بر الگوریتم های داخلی SageMaker و مدل های JumpStart
- نمایش عملی الگوریتم های SageMaker
- راه اندازی و اجرای SageMaker Training Jobs
- نمایش عملی فرآیند آموزش در SageMaker
- تنظیم Hyperparameterها با SageMaker Automatic Model Tuning
- نمایش عملی تنظیم Hyperparameterها
- جلوگیری از Overfitting و Underfitting
- نمایش عملی Overfitting و Underfitting مدل
فصل ششم: ارزیابی مدل و تشخیص Bias
- اهداف یادگیری
- معیارهای ارزیابی مدل: Accuracy، Precision و Recall
- استفاده از SageMaker Clarify برای تشخیص Bias و تفسیرپذیری مدل
- مقایسه عملکرد مدل با استفاده از A/B Testing
- نمایش عملی A/B Testing مدل
- مدیریت نسخه های مدل با SageMaker Model Registry
- نمایش عملی Model Registry
فصل هفتم: استقرار مدل ها با SageMaker
- مقدمه ماژول
- اهداف یادگیری
- Inference بلادرنگ با SageMaker Endpoints
- نمایش عملی Inference بلادرنگ
- Batch Inference و Asynchronous Inference
- نمایش عملی Batch Inference و Asynchronous Inference
- استفاده از SageMaker Neo برای استقرار در Edge
- نمایش عملی استقرار مدل در Edge با SageMaker
فصل هشتم: خودکارسازی گردش کارهای ML با SageMaker Pipelines
- اهداف یادگیری
- ساخت و خودکارسازی ML Pipelines در SageMaker
- نمایش عملی SageMaker Pipeline
- یکپارچه سازی مراحل پردازش داده و آموزش مدل
- نمایش عملی آموزش و پردازش داده در SageMaker Pipelines
- اجرای مجدد Pipelineها برای آموزش مجدد مدل با EventBridge
- نمایش عملی اجرای SageMaker Pipelines از طریق EventBridge
فصل نهم: مانیتورینگ و بهینه سازی راهکارهای ML
- مقدمه ماژول
- اهداف یادگیری
- استفاده از SageMaker Model Monitor برای بررسی Data Drift و کیفیت داده
- نمایش عملی SageMaker Model Monitor
- راه اندازی Alertها و Dashboardهای CloudWatch
- بهینه سازی هزینه با Auto Scaling و SageMaker Savings Plans
- نمایش عملی Auto Scaling در SageMaker
فصل دهم: تأمین امنیت مدل ها و داده ها در SageMaker
- اهداف یادگیری
- IAM Roles و مجوزها در SageMaker
- نمایش عملی IAM
- پیکربندی VPC برای استقرار امن Endpointها
- نمایش عملی VPC
فصل یازدهم: جمع بندی
- جمع بندی یادگیری ماشین با SageMaker
محصولات مرتبط