پرووید
آموزش کار با جداول در SQL Server
آموزش کار با جداول در SQL Server یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. این بسته آموزشی نیز یکی از دوره های آموزشی دیگر که در حوزه فارسی سازی آموزش های انگلیسی تنظیم شده است می باشد. عنوان این بسته آموزشی، آموزش طراحی و پیاده سازی جداول در SQL Server است که با نام اصلی Designing and Implementing SQL Server Tables and Views از شرکت Pluralsight منتشر شده است.
جداول SQL Server: ساختار داده ها برای ذخیره سازی و بازیابی کارآمد
جداول در SQL Server یک ساختار اساسی برای سازماندهی و ذخیره داده ها در یک سیستم پایگاه داده رابطه ای را تشکیل می دهند. طراحی صحیح جداول شامل تعریف انواع داده های مناسب، ایجاد روابط کلید اولیه و خارجی، و اعمال محدودیت های یکپارچگی داده ها و یا همان data integrity constraint از طریق constraint ها و index ها می باشد.
تکنیکهای نرمال سازی به کاهش افزونگی و اطمینان از سازگاری دادهها کمک میکند، در حالی که غیرنرمال سازی ممکن است برای بهینهسازی عملکرد در سناریوهای خاص استفاده شود. استراتژی های ایندکس سازی کارآمد، مانند ایندکس های خوشه ای و غیر خوشه ای، عملکرد پرس و جو را با تسهیل بازیابی سریع داده ها بر اساس معیارهای مشخص، افزایش می دهند.
کاربرد View ها در SQL Server: ساده سازی دسترسی به داده ها و پرس و جو
در SQL Server قابلیت View مکانیسم قدرتمندی برای ساده کردن دسترسی به داده ها و پرس و جو با کپسوله کردن منطق پیچیده SQL در جداول مجازی را فراهم می کند. این view ها میتوانند پیچیدگی مدلهای داده ها را از بین ببرند و به کاربران یک رابط ساده شده و سطح بالا برای بازیابی اطلاعات ارائه دهند.
آنها قابلیت استفاده مجدد کد را با متمرکز کردن منطق پرس و جو رایج ایجاد می کنند و با افشای تنها داده های مربوط به کاربران یا برنامه ها، امکان کنترل دسترسی دقیق را فراهم می کنند. بهعلاوه، view ها میتوانند عملکرد را با پیشمحاسبهسازی و ذخیرهسازی نتایج پرسوجو افزایش دهند و هزینههای سربار اجرای مکرر پرسوجوهای پیچیده را کاهش دهند.
نرمالسازی دادهها در SQL Server چگونه انجام میشود؟
نرمالسازی یکی از اصول مهم طراحی پایگاه دادههای رابطهای است که به کاهش افزونگی دادهها و جلوگیری از بروز ناسازگاری هنگام ثبت و بهروزرسانی اطلاعات کمک میکند. در SQL Server، با تقسیم دادهها میان جداول مرتبط و تعریف روابط مناسب میتوان ساختاری منظمتر برای ذخیرهسازی اطلاعات ایجاد کرد. آشنایی با اصول نرمالسازی به توسعهدهندگان کمک میکند تصمیمهای دقیقتری درباره ساختار جداول بگیرند و نگهداری پایگاه داده را سادهتر کنند.
در طراحی جداول، انتخاب ساختار مناسب برای هر موجودیت و مشخص کردن ارتباط میان اطلاعات اهمیت زیادی دارد. اگر دادههای تکراری بهدرستی مدیریت نشوند، تغییر یک مقدار ممکن است به اصلاح چندین رکورد نیاز داشته باشد و احتمال ایجاد خطا افزایش پیدا کند. استفاده از اصول نرمالسازی در SQL Server میتواند این مشکلات را کاهش دهد و زمینه را برای توسعه و نگهداری بهتر برنامههایی فراهم کند که به دادههای رابطهای وابسته هستند.
Constraint در SQL Server چیست و چه کاربردی دارد؟
Constraint در SQL Server محدودیتی است که برای کنترل مقادیر مجاز و حفظ یکپارچگی دادهها در جدول تعریف میشود. برای مثال، Primary Key هویت یکتای هر رکورد را مشخص میکند، Foreign Key ارتباط معتبر میان جداول را کنترل میکند و Unique از تکرار مقادیر مشخص جلوگیری میکند. همچنین Check و Default میتوانند بهترتیب برای اعتبارسنجی مقادیر و تعیین مقدار پیشفرض ستونها به کار بروند.
استفاده صحیح از Constraintها باعث میشود بسیاری از قوانین مربوط به صحت دادهها مستقیماً در سطح پایگاه داده اعمال شوند. این رویکرد اهمیت زیادی دارد، زیرا ممکن است اطلاعات از مسیرهای مختلفی وارد سیستم شوند و تنها اعتبارسنجی در کد برنامه برای کنترل همه شرایط کافی نباشد. شناخت محدودیتهای SQL Server به توسعهدهندگان کمک میکند ساختارهای مطمئنتری طراحی کنند و از ثبت اطلاعات نامعتبر یا ایجاد روابط ناسازگار میان جداول جلوگیری کنند.
Indexed View و Partitioned View در SQL Server
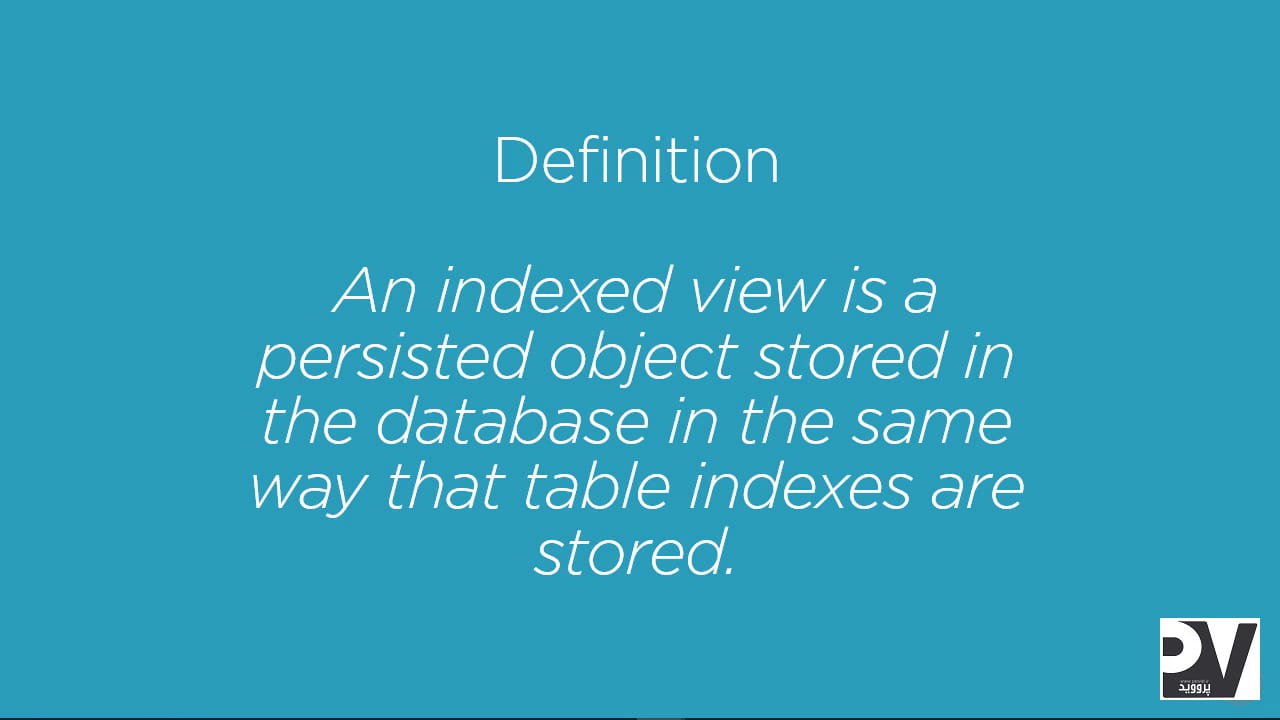
Indexed View یکی از قابلیتهای SQL Server است که با ایجاد ایندکس روی یک View واجد شرایط، امکان ذخیرهسازی فیزیکی نتایج آن را فراهم میکند. این قابلیت میتواند برای برخی پرسوجوهای پرتکرار و محاسباتی که هزینه اجرای بالایی دارند مفید باشد. بااینحال، استفاده از Indexed View به شرایط و محدودیتهای مشخصی وابسته است و تغییرات دادههای جداول پایه نیز میتواند هزینه نگهداری ایندکس را افزایش دهد.
Partitioned View روشی برای ارائه یک نمای یکپارچه از دادههایی است که در چند جدول مجزا قرار دارند. در شرایط مناسب، این روش امکان سازماندهی دادهها بر اساس معیارهایی مانند محدوده مقادیر را فراهم میکند و میتواند برای کار با مجموعههای تفکیکشده اطلاعات کاربرد داشته باشد. شناخت تفاوت این دو قابلیت به طراحان پایگاه داده کمک میکند هنگام انتخاب راهکار مناسب، نیازهای دسترسی به دادهها، ساختار جداول و هزینههای نگهداری را در نظر بگیرند.
سرفصل مطالب آموزش ویدئویی کار با جداول در SQL Server
فصل اول: مقدمه دوره آموزشی- مقدمه دوره آموزشی
- بررسی نسخه
- مقدمه
- مبانی پایگاه داده رابطه ای
- معرفی Azure Data Studio
- معرفی پروژه این دوره آموزشی
- مروری بر محتوای این آموزشی
- مقدمه
- ایجاد شناسه ها
- استفاده از قراردادهای نامگذاری
- استفاده از انواع داده های کاراکتر
- استفاده از انواع عدد صحیح
- استفاده از انواع اعشاری
- استفاده از انواع تاریخ و زمان
- آموزش عملی ایجاد جدول پیگیری سفارش
- استفاده از Collation ها
- آموزش عملی استفاده از Collation ها
- جمع بندی
- مقدمه
- شناسایی مشکلات مربوط به داده های غیر نرمال
- تعیین اهداف برای نرمال سازی
- آموزش عملی کشف ناهنجاری ها با داده های غیر نرمال
- درک اولین فرم نرمال
- آموزش عملی تبدیل به 1NF
- درک فرم دوم نرمال
- آموزش عملی تبدیل به 2NF
- درک سومین فرم نرمال
- آموزش عملی تبدیل به 3NF
- در نظر گرفتن سایر اشکال نرمال
- جمع بندی
- مقدمه
- استفاده از محدودیت های NULL و DEFAULT
- آموزش عملی محدودیت های NULL و DEFAULT
- اجرای محدودیت PRIMARY KEY
- استفاده از ایندکس و محدودیت UNIQUE
- آموزش عملی پیاده سازی محدودیت های PRIMARY KEY و UNIQUE
- اطلاعات بیشتر درباره محدودیت های Foreign Key
- آموزش عملی استفاده از محدودیت های Foreign Key
- معرفی محدودیت های CHECK
- آموزش عملی استفاده از محدودیت های CHECK
- گزینه هایی برای تعریف محدودیت های CHECK
- جمع بندی
- مقدمه
- بررسی اجمالی و انگیزه
- بررسی طراحی سیستم سفارش کفش Bobs
- آموزش عملی ایجاد یک View برای تولید فهرستی از مشتریان
- آموزش عملی با استفاده از SCHEMABINDING
- کار با View های به روز رسانی
- آموزش عملی به روز رسانی جداول با استفاده از View ها
- جمع بندی
- مقدمه
- الزامات برای Indexed View ها
- آموزش عملی Determinism
- الزامات بیشتر برا Indexed View ها
- آموزش عملی ایندکس گذاری برای یک View
- آموزش عملی اضافه کردن یک ایندکس غیرکلاستری و View ها با Aggregate ها
- جمع بندی
- معرفی Partitioned View
- تشریح Partitioned View
- بررسی الزامات و محدودیت ها
- آموزش عملی ایجاد Partitioned View برای جدول سفارشات
- طراحی و به روز رسانی Partitioned View ها
- جمع بندی
- مقدمه
- طراحی جداول
- طراحی و پیاده سازی جداول و View ها
- در نظر گرفتن سایر انواع جدول
- نگاهی به انواع داده های دیگر
- جمع بندی
محصولات مرتبط