آموزش مفاهیم پایه یادگیری تقویتی (Reinforcement Learning)
آموزش مفاهیم پایه یادگیری تقویتی با عنوان اصلی Reinforcement Learning Foundations یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. در این دوره با مفاهیم اصلی Reinforcement Learning، نحوه تعریف مسائل یادگیری تقویتی و فرایند تصمیمگیری بر اساس پاداش آشنا میشوید. همچنین الگوریتمهای مهمی مانند Monte Carlo، Temporal Difference و Q-learning را بررسی میکنید و با رویکردهای پیشرفتهتری مانند Deep Reinforcement Learning و Multi-Agent Reinforcement Learning آشنا خواهید شد. محتوای این دوره به زبان انگلیسی و همراه با زیرنویس انگلیسی ارائه شده است.
یادگیری تقویتی چیست و چگونه کار میکند؟
یادگیری تقویتی (Reinforcement Learning) یکی از شاخههای Machine Learning است که در آن یک عامل هوشمند با تعامل با محیط، یاد میگیرد چگونه تصمیمهای مناسبی بگیرد. عامل بر اساس اقداماتی که انجام میدهد، پاداش یا جریمه دریافت میکند و با استفاده از این بازخوردها، بهتدریج راهبرد خود را بهبود میبخشد. هدف معمولاً پیدا کردن سیاستی است که مجموع پاداشهای دریافتی را در طول زمان به حداکثر برساند.
این روش با یادگیری نظارتشده تفاوت دارد؛ زیرا در بسیاری از مسائل یادگیری تقویتی، پاسخ صحیح برای هر ورودی از قبل مشخص نیست و عامل باید از تجربههای خود یاد بگیرد. برای مثال، یک عامل میتواند با انجام اقدامات مختلف در یک محیط شبیهسازیشده، پیامد تصمیمهایش را بررسی کند و بهمرور انتخابهای بهتری داشته باشد. درک این سازوکار، نقطه شروع مناسبی برای آشنایی با الگوریتمها و مدلهای مختلف یادگیری تقویتی است.
مفاهیم پایه و فرایند تصمیمگیری در Reinforcement Learning
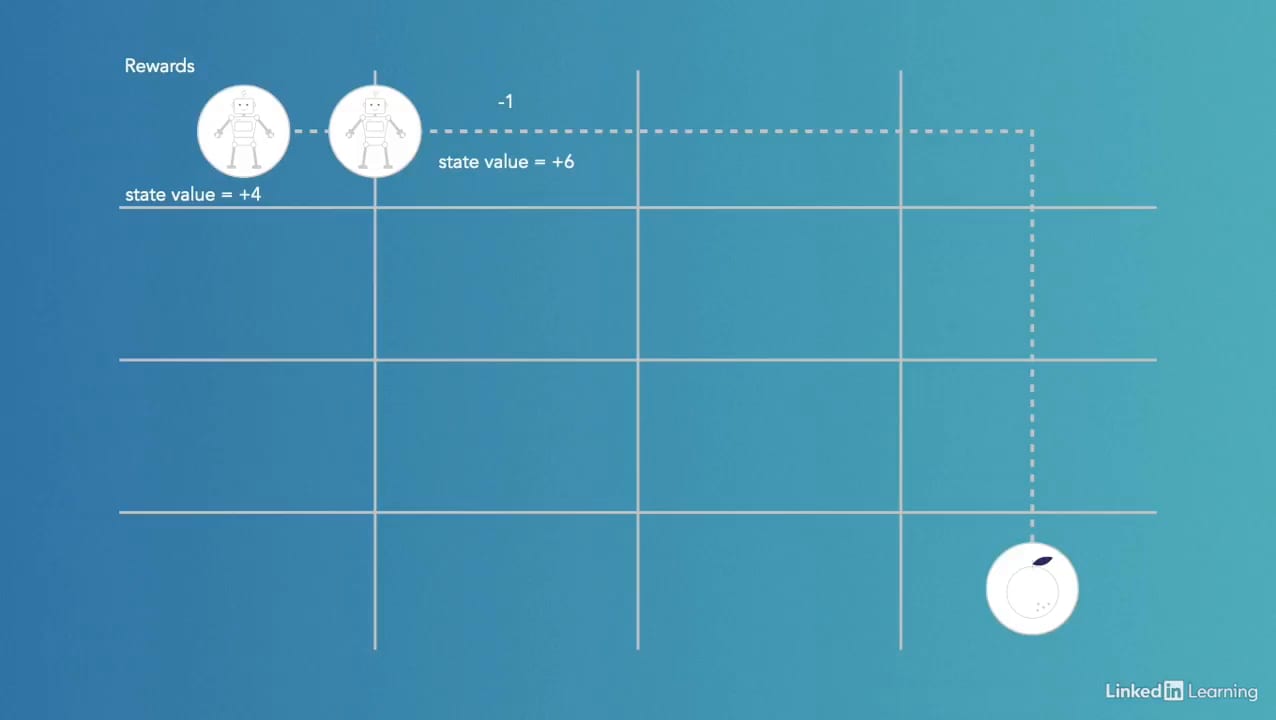
برای طراحی یک مسئله یادگیری تقویتی، باید مفاهیمی مانند Agent، Environment، State، Action و Reward را بشناسید. عامل تصمیمگیرندهای است که با محیط تعامل میکند، وضعیت فعلی را مشاهده میکند و اقدامی را انتخاب میکند. محیط نیز بر اساس آن اقدام، وضعیت جدید و پاداش مربوطه را ارائه میدهد. این تعامل به عامل امکان میدهد پیامد تصمیمهای مختلف را بررسی کند و برای رسیدن به اهداف خود، رفتار مناسبتری یاد بگیرد.
یکی از مدلهای مهم برای تعریف این مسائل، Markov Decision Process یا MDP است. این چارچوب، وضعیتها، اقدامات، پاداشها و احتمال انتقال میان وضعیتها را توصیف میکند و مبنای بسیاری از الگوریتمهای یادگیری تقویتی محسوب میشود. در این آموزش با ساختار یک مسئله پایه و نحوه شکلگیری یک راهحل آشنا میشوید. این مفاهیم به شما کمک میکنند هنگام مطالعه الگوریتمهای پیشرفتهتر، ارتباط میان تصمیمها، پاداشها و نتایج بلندمدت را بهتر درک کنید.
الگوریتمهای یادگیری تقویتی و تفاوت روشهای اصلی
الگوریتمهای یادگیری تقویتی روشهای مختلفی برای تخمین ارزش تصمیمها، ارزیابی سیاستها و پیدا کردن اقدامات مناسب ارائه میکنند. انتخاب الگوریتم به عواملی مانند ساختار مسئله، اطلاعات در دسترس و نحوه تعامل عامل با محیط بستگی دارد. در این حوزه، روشهای Monte Carlo و Temporal Difference از رویکردهای مهم برای یادگیری از تجربه هستند و هر کدام شیوه متفاوتی برای استفاده از بازخوردها و تخمین ارزش وضعیتها دارند.
در روش Monte Carlo، تخمینها معمولاً بر اساس بازده حاصل از تجربههای کامل انجام میشوند؛ در حالی که روشهای Temporal Difference میتوانند تخمینهای خود را با استفاده از اطلاعات مراحل میانی بهروزرسانی کنند. در کنار این دو رویکرد، الگوریتمهای دیگری نیز برای شرایط و اهداف متفاوت توسعه یافتهاند. آشنایی با این تفاوتها باعث میشود درک بهتری از نحوه یادگیری عامل پیدا کنید و بتوانید منطق انتخاب روش مناسب برای یک مسئله مشخص را بررسی کنید.
روش Monte Carlo و مفاهیم Exploration و Exploitation
روش Monte Carlo یکی از رویکردهای یادگیری تقویتی است که برای تخمین ارزش وضعیتها یا اقدامات از بازده تجربههای اجراشده استفاده میکند. در این روش، عامل میتواند مسیرهای مختلفی را در محیط طی کند و پس از مشاهده نتایج، تخمینهای خود را بهروزرسانی کند. درک شرایط اجرای این روش و نحوه پیشبینی ارزش وضعیتها، زمینه لازم را برای آشنایی با روشهای کنترل و بهبود سیاست تصمیمگیری فراهم میکند.
یکی از موضوعات مهم در این بخش، تعادل میان Exploration و Exploitation است. Exploration به معنای بررسی اقدامات جدید برای کسب اطلاعات بیشتر است، در حالی که Exploitation به استفاده از دانستههای فعلی برای انتخاب اقداماتی با بازده مورد انتظار بالاتر اشاره دارد. در ادامه، تفاوت روشهای First-Visit و Every-Visit در تخمین Monte Carlo و همچنین Monte Carlo Control بررسی میشود. این مفاهیم نشان میدهند چگونه تجربههای عامل میتوانند برای ارزیابی و بهبود سیاستهای تصمیمگیری به کار گرفته شوند.
روش Temporal Difference و الگوریتمهای SARSA و Q-learning
روشهای Temporal Difference یا TD امکان بهروزرسانی تخمین ارزش را با استفاده از اطلاعات فعلی و تخمینهای مربوط به مراحل بعدی فراهم میکنند. برخلاف روشهایی که برای محاسبه بازده به پایان یک مسیر کامل نیاز دارند، این رویکردها میتوانند در طول تعامل عامل با محیط یاد بگیرند. به همین دلیل، Temporal Difference یکی از مفاهیم مهم در مطالعه الگوریتمهای یادگیری تقویتی و طراحی عاملهایی است که باید در محیطهای پویا تصمیمگیری کنند.
در این بخش با الگوریتمهای SARSA، Q-learning و Expected SARSA آشنا میشوید. SARSA ارزش اقدامها را بر اساس مسیر تصمیمگیری عامل بهروزرسانی میکند، در حالی که Q-learning از هدف بهروزرسانی مبتنی بر بیشترین ارزش تخمینی اقدام بعدی استفاده میکند. Expected SARSA نیز بهجای تکیه بر یک اقدام مشخص بعدی، از میانگین مورد انتظار ارزش اقدامها بر اساس سیاست استفاده میکند. شناخت این تفاوتها به درک بهتر نحوه یادگیری سیاستهای تصمیمگیری کمک میکند.
انواع پیشرفته یادگیری تقویتی و کاربردهای آن
یادگیری تقویتی تنها به الگوریتمهای پایه محدود نمیشود و در مسائل پیچیدهتر نیز توسعه پیدا کرده است. یکی از این رویکردها Deep Reinforcement Learning است که از شبکههای عصبی عمیق برای تخمین ارزشها یا یادگیری سیاستها استفاده میکند. این ترکیب میتواند در مسائلی مفید باشد که فضای وضعیتها یا اقدامات بسیار بزرگ است و نمایش یا پردازش اطلاعات با روشهای سادهتر دشوار میشود. درک ارتباط Deep Learning با یادگیری تقویتی، دید گستردهتری درباره قابلیتهای این حوزه ایجاد میکند.
در Multi-Agent Reinforcement Learning، چند عامل در یک محیط مشترک یاد میگیرند و ممکن است با یکدیگر همکاری یا رقابت کنند. این شرایط، مسئله یادگیری را پیچیدهتر میکند؛ زیرا اقدامات هر عامل میتواند بر نتایج سایر عاملها تأثیر بگذارد. رویکرد دیگری به نام Inverse Reinforcement Learning نیز تلاش میکند با مشاهده رفتار یک عامل، اطلاعاتی درباره پاداش یا هدفی که رفتار او را هدایت میکند به دست آورد. آشنایی با این شاخهها به شما کمک میکند مسیرهای مختلف توسعه و استفاده از یادگیری تقویتی را بشناسید.
این آموزش برای چه کسانی مناسب است؟
این دوره برای برنامهنویسان، علاقهمندان به هوش مصنوعی و افرادی مناسب است که میخواهند با اصول Reinforcement Learning آشنا شوند. اگر پیشتر مفاهیم پایه Machine Learning را مطالعه کردهاید و قصد دارید روشهای تصمیمگیری مبتنی بر پاداش را بهتر بشناسید، مباحث این آموزش میتوانند درک شما را از ساختار مسائل، الگوریتمهای یادگیری و نحوه ارزیابی تصمیمها تقویت کنند. همچنین برای افرادی مفید است که میخواهند تفاوت رویکردهای Monte Carlo و Temporal Difference را بهصورت مفهومی بررسی کنند.
در طول دوره، از مفاهیم اولیه و تعریف مسئله تا الگوریتمهای پایه و انواع پیشرفتهتر یادگیری تقویتی پیش میروید. آشنایی با SARSA، Q-learning، Deep Reinforcement Learning و Multi-Agent Reinforcement Learning میتواند زمینهای برای مطالعه عمیقتر این الگوریتمها و پیادهسازی آنها در پروژههای هوش مصنوعی فراهم کند. این آموزش همچنین برای کسانی مناسب است که میخواهند پیش از ورود به مباحث تخصصیتر، یک دید کلی و منسجم از مفاهیم و روشهای اصلی یادگیری تقویتی به دست آورند.
سرفصل مطالب آموزش ویدئویی مفاهیم پایه یادگیری تقویتی (Reinforcement Learning)
فصل اول: مقدمه
- یادگیری تقویتی در یک نگاه
فصل دوم: شروع کار با یادگیری تقویتی
- اصطلاحات یادگیری تقویتی
- یک مسئله پایه در یادگیری تقویتی
- فرایند تصمیمگیری مارکوف
- یک راهکار پایه برای یادگیری تقویتی
فصل سوم: الگوریتمهای یادگیری تقویتی
- روش مونتکارلو
- روشهای اختلاف زمانی
- سایر الگوریتمهای یادگیری تقویتی
فصل چهارم: روش مونتکارلو
- چارچوب مسئله
- اکتشاف و بهرهبرداری
- پیشبینی با روش مونتکارلو
- پیشبینی مونتکارلو با روش اولین بازدید و هر بازدید
- کنترل مونتکارلو
- تغییرات و اصلاحات تکمیلی
فصل پنجم: روشهای اختلاف زمانی
- چارچوب مسئله
- SARSA
- SARSAMAX (Q-learning)
- Expected SARSA
فصل ششم: شکلهای توسعهیافته یادگیری تقویتی
- یادگیری تقویتی عمیق
- یادگیری تقویتی چندعاملی
- یادگیری تقویتی معکوس
فصل هفتم: جمع بندی
- مسیر یادگیری شما در زمینه یادگیری تقویتی
محصولات مرتبط


دیدگاه ها