پرووید
آموزش کاربردی Python برای علم داده و یادگیری ماشین (بخش دوم)
آموزش کاربردی Python برای علم داده و یادگیری ماشین با عنوان اصلی Python for Data Science and Machine Learning Essential Training Part 2 یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. در این دوره با الگوریتم ها و مدل های مختلف یادگیری ماشین آشنا می شوید و یاد می گیرید چگونه با استفاده از Python مسائل پیش بینی، خوشه بندی و کاهش ابعاد داده ها را حل کنید. همچنین مبانی پردازش زبان طبیعی (NLP) و مدل های هوش مصنوعی مولد (Generative AI) را بررسی می کنید و با پیاده سازی عملی یک مدل Generative AI آشنا خواهید شد.
یادگیری ماشین (Machine Learning) چیست و چه کاربردی دارد؟
یادگیری ماشین یکی از شاخه های هوش مصنوعی است که به سیستم ها امکان می دهد با استفاده از داده ها، الگوها و روابط موجود را شناسایی کنند و بر اساس آن ها پیش بینی یا تصمیم گیری انجام دهند. این فناوری در حوزه های مختلفی مانند تحلیل رفتار کاربران، تشخیص تقلب، پیش بینی فروش و دسته بندی اطلاعات کاربرد دارد. برای استفاده مؤثر از الگوریتم های یادگیری ماشین، ابتدا باید با مفاهیم پایه، انواع الگوریتم ها و مراحل اصلی ساخت مدل آشنا شوید.
در این بخش با جایگاه یادگیری ماشین در علم داده و مبانی هوش مصنوعی آشنا می شوید. همچنین الگوریتم های یادگیری ماشین را بر اساس رویکرد و نوع مسئله دسته بندی می کنید و یک نقشه راه کلی برای اجرای پروژه های این حوزه خواهید شناخت. این مباحث به شما کمک می کنند هنگام مواجهه با یک مسئله واقعی، روش مناسب را انتخاب کنید و مراحل آماده سازی داده، آموزش مدل و ارزیابی نتایج را بهتر درک کنید.
مدل های رگرسیون در Python چیستند؟
مدل های رگرسیون از روش های مهم یادگیری ماشین برای بررسی ارتباط میان متغیرها و پیش بینی مقادیر هستند. برای مثال، می توان با استفاده از اطلاعات مربوط به ویژگی های یک خانه، قیمت احتمالی آن را تخمین زد. رگرسیون خطی ساده و رگرسیون خطی چندگانه از روش های رایج این حوزه هستند. همچنین رگرسیون لجستیک برای مسائل دسته بندی به کار می رود و امکان پیش بینی تعلق یک نمونه به یک کلاس مشخص را فراهم می کند.
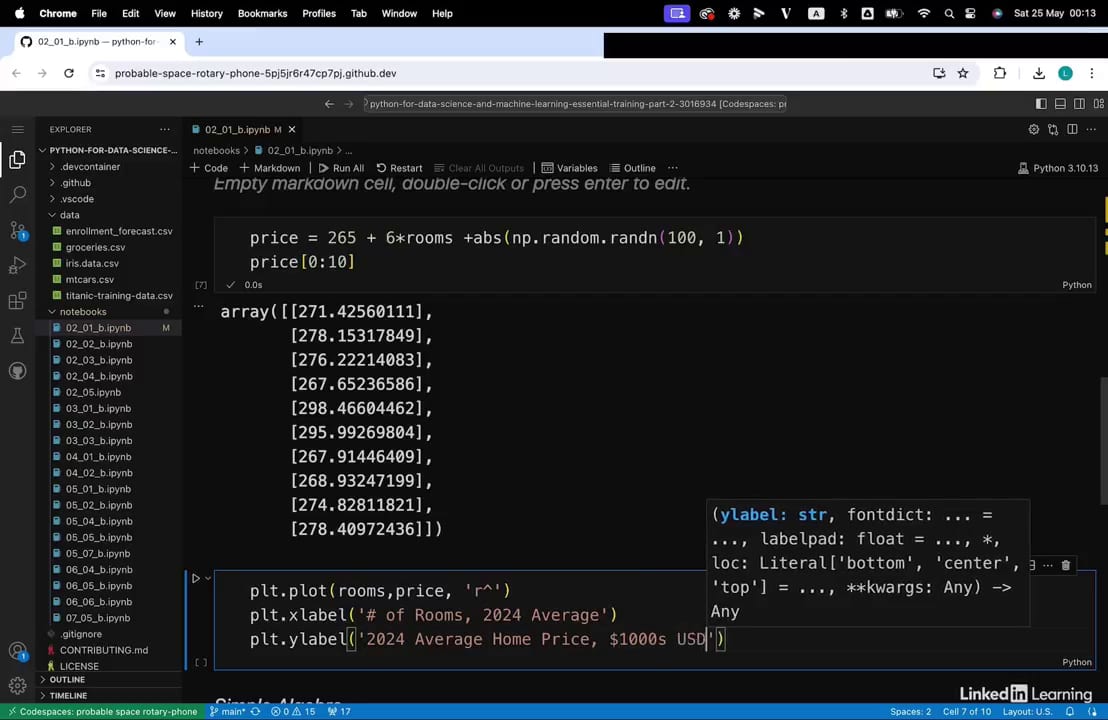
در این آموزش با ساخت مدل های مختلف رگرسیون و مراحل آماده سازی داده برای آن ها آشنا می شوید. مدیریت مقادیر گمشده، بازکدگذاری متغیرها، اعتبارسنجی مجموعه داده و استقرار مدل از موضوعات مورد بررسی هستند. همچنین یاد می گیرید چگونه عملکرد مدل را ارزیابی کنید و با استفاده از آن پیش بینی های آزمایشی انجام دهید. این مهارت ها درک عملی شما از چرخه ساخت و ارزیابی مدل های یادگیری ماشین را تقویت می کنند.
خوشه بندی داده ها با K-means و الگوریتم های دیگر
خوشه بندی (Clustering) یکی از روش های یادگیری ماشین بدون نظارت است که برای گروه بندی داده های مشابه استفاده می شود. در این روش، الگوریتم بدون نیاز به برچسب های از پیش تعیین شده، تلاش می کند نمونه هایی را که ویژگی های نزدیک به یکدیگر دارند در یک گروه قرار دهد. برای مثال، در تحلیل مشتریان می توان افراد را بر اساس رفتار خرید یا ویژگی های مشترک به چند گروه تقسیم کرد.
در این بخش با روش K-means برای تحلیل خوشه ای و همچنین خوشه بندی سلسله مراتبی آشنا می شوید. هر یک از این روش ها رویکرد متفاوتی برای شناسایی ساختار گروه ها در داده ها دارند. علاوه بر این، الگوریتم DBSCAN را بررسی می کنید که می تواند برای شناسایی نقاط پرت نیز مورد استفاده قرار گیرد. آشنایی با این روش ها به شما کمک می کند برای تحلیل مجموعه داده های بدون برچسب، الگوریتم مناسب تری انتخاب کنید.
کاهش ابعاد داده ها با PCA و تحلیل عاملی
در بسیاری از پروژه های علم داده، مجموعه اطلاعات شامل تعداد زیادی متغیر و ویژگی است. وجود متغیرهای متعدد می تواند تحلیل داده ها را پیچیده تر کند و شناسایی الگوهای اصلی را دشوار سازد. روش های کاهش ابعاد (Dimensionality Reduction) با هدف ساده سازی ساختار داده ها و کاهش تعداد ویژگی ها به کار می روند. این روش ها تلاش می کنند اطلاعات مهم را حفظ کنند و در عین حال پیچیدگی مجموعه داده را کاهش دهند.
در این دوره با تحلیل عاملی اکتشافی (Exploratory Factor Analysis) و تحلیل مؤلفه های اصلی (Principal Component Analysis یا PCA) آشنا می شوید. PCA با تبدیل ویژگی های اولیه به مجموعه ای از مؤلفه های جدید، امکان نمایش بخش مهمی از اطلاعات در ابعاد کمتر را فراهم می کند. تحلیل عاملی نیز برای بررسی ساختار روابط میان متغیرها و شناسایی عوامل پنهان کاربرد دارد. شناخت این روش ها برای تحلیل داده های پیچیده و چندبعدی اهمیت زیادی دارد.
الگوریتم های پرکاربرد یادگیری ماشین در Python
علاوه بر رگرسیون و خوشه بندی، الگوریتم های متنوع دیگری نیز برای حل مسائل یادگیری ماشین وجود دارند. هر الگوریتم بر اساس منطق متفاوتی کار می کند و برای دسته خاصی از مسائل مناسب است. برای مثال، برخی روش ها روابط میان متغیرها را بررسی می کنند، برخی بر اساس نمونه های مشابه تصمیم می گیرند و برخی دیگر با ترکیب چند مدل، دقت پیش بینی را بهبود می بخشند.
در این بخش با الگوریتم هایی مانند Apriori برای استخراج قوانین انجمنی، KNN برای یادگیری مبتنی بر نمونه، درخت تصمیم CART و Naïve Bayes بر اساس آمار بیزی آشنا می شوید. همچنین روش های Ensemble Learning با Random Forest و شبکه های عصبی مبتنی بر Perceptron را بررسی می کنید و با ساخت یک شبکه عصبی آشنا خواهید شد. این مجموعه از الگوریتم ها دید گسترده تری درباره روش های حل مسائل مختلف با یادگیری ماشین در اختیار شما قرار می دهد.
پردازش زبان طبیعی (NLP) با Python چیست؟
پردازش زبان طبیعی یا Natural Language Processing شاخه ای از هوش مصنوعی است که به کامپیوترها امکان می دهد داده های متنی و زبان انسانی را پردازش و تحلیل کنند. این فناوری در کاربردهایی مانند تحلیل احساسات، دسته بندی متن، استخراج اطلاعات و پردازش اسناد استفاده می شود. از آنجا که داده های متنی معمولاً شامل کلمات تکراری، شکل های مختلف نوشتاری و اطلاعات غیرضروری هستند، آماده سازی متن یکی از مراحل مهم در پروژه های NLP محسوب می شود.
در این بخش با مبانی پردازش زبان طبیعی و روش های آماده سازی داده های متنی آشنا می شوید. پاک سازی متن و Stemming برای کاهش شکل های مختلف کلمات به ریشه آن ها از موضوعات این قسمت هستند. همچنین روش Lemmatization را بررسی می کنید که کلمات را با توجه به ساختار زبانی به شکل پایه خود تبدیل می کند. این مهارت ها به شما کمک می کنند داده های متنی را برای تحلیل و پردازش های بعدی آماده کنید.
هوش مصنوعی مولد (Generative AI) و پیاده سازی مدل ها
هوش مصنوعی مولد یا Generative AI به دسته ای از مدل های هوش مصنوعی گفته می شود که می توانند بر اساس الگوهای یادگرفته شده، محتوای جدیدی مانند متن، تصویر یا سایر خروجی های داده ای تولید کنند. این فناوری در سال های اخیر به یکی از حوزه های مهم هوش مصنوعی تبدیل شده است و شناخت مبانی آن برای توسعه دهندگانی که در زمینه علم داده و یادگیری ماشین فعالیت می کنند، اهمیت زیادی دارد.
در بخش پایانی دوره، ساختار و عملکرد مدل های Generative AI را با جزئیات بیشتری بررسی می کنید و با روند تحولات این حوزه آشنا می شوید. همچنین یک نمونه کدنویسی عملی برای پیاده سازی مدل هوش مصنوعی مولد انجام می دهید تا ارتباط میان مفاهیم نظری و استفاده از آن ها در برنامه نویسی را بهتر درک کنید. در پایان نیز منابع تکمیلی و مسیرهای پیشنهادی برای ادامه یادگیری معرفی می شوند. این دوره به زبان انگلیسی ارائه شده و دارای زیرنویس انگلیسی است.
سرفصل مطالب آموزش ویدئویی کاربردی Python برای علم داده و یادگیری ماشین (بخش دوم)
فصل اول: مقدمه
- ترفندهای کاربردی برای کار در علم داده
- پیشنیازها و دانستههای موردنیاز
- نحوه استفاده از Codespaces در این دوره
فصل دوم: مقدمهای بر یادگیری ماشین
- تعریف علم داده
- آشنایی با جایگاه یادگیری ماشین در علم داده
- مبانی هوش مصنوعی و یادگیری ماشین
- دستهبندی الگوریتمهای یادگیری ماشین
- نقشه راه کلی یادگیری ماشین
فصل سوم: مدلهای رگرسیون
- رگرسیون خطی
- رگرسیون خطی چندگانه
- مفاهیم رگرسیون لجستیک
- آمادهسازی دادهها برای رگرسیون لجستیک
- مدیریت مقادیر گمشده در رگرسیون لجستیک
- کدگذاری مجدد متغیرها در رگرسیون لجستیک
- اعتبارسنجی مجموعه داده در رگرسیون لجستیک
- استقرار مدل رگرسیون لجستیک
- ارزیابی مدل رگرسیون لجستیک
- پیشبینی آزمایشی با رگرسیون لجستیک
فصل چهارم: مدلهای خوشهبندی
- تحلیل خوشهای با روش K-means
- تحلیل خوشهای سلسلهمراتبی
- استفاده از DBSCAN برای شناسایی دادههای پرت
فصل پنجم: روشهای کاهش ابعاد
- تحلیل عاملی اکتشافی
- تحلیل مؤلفههای اصلی (PCA)
فصل ششم: سایر روشهای پرکاربرد یادگیری ماشین
- مدلسازی قوانین انجمنی با الگوریتم Apriori
- یادگیری مبتنی بر نمونه با KNN
- درختهای تصمیم با CART
- آمار بیزی با Naïve Bayes
- یادگیری ترکیبی با Random Forest
- شبکههای عصبی با Perceptron
- ساخت یک شبکه عصبی
فصل هفتم: شروع کار با پردازش زبان طبیعی
- مقدمهای بر پردازش زبان طبیعی (NLP)
- پاکسازی دادههای متنی و ریشهیابی کلمات (Stemming)
- Lemmatization و تحلیل دادههای متنی
فصل هشتم: شروع کار با مدلهای هوش مصنوعی مولد
- بررسی عمیق مدلهای هوش مصنوعی مولد
- آشنایی با آخرین تحولات هوش مصنوعی
- نمایش عملی کدنویسی و پیادهسازی یک مدل هوش مصنوعی مولد
فصل نهم: جمعبندی
- گامهای بعدی و منابع تکمیلی
محصولات مرتبط