پرووید
آموزش کاربردی Python برای علم داده و یادگیری ماشین (بخش اول)
آموزش کاربردی Python برای علم داده و یادگیری ماشین با عنوان اصلی Python for Data Science and Machine Learning Essential Training Part 1 یکی دیگر از آموزش های گروه آموزشی پرووید می باشد که در این قسمت آن را به شما معرفی می کنیم. در این دوره با کاربرد Python در علم داده و تحلیل اطلاعات آشنا می شوید و یاد می گیرید چگونه داده ها را آماده سازی، پاک سازی، تحلیل و به صورت نمودارهای قابل فهم نمایش دهید. همچنین مبانی اولیه یادگیری ماشین، جمع آوری اطلاعات از وب و ساخت داشبوردهای تعاملی با Streamlit را به صورت کاربردی فرا می گیرید.
علم داده (Data Science) چیست و چرا به Python نیاز داریم؟
علم داده حوزه ای است که با استفاده از روش های آماری، برنامه نویسی و تحلیل اطلاعات، به استخراج دانش و الگوهای ارزشمند از داده ها می پردازد. متخصصان این حوزه در موقعیت های شغلی مختلفی فعالیت می کنند و بسته به مهارت ها و علاقه خود می توانند در زمینه هایی مانند تحلیل داده، مهندسی داده یا یادگیری ماشین تخصص پیدا کنند. Python به دلیل سادگی، انعطاف پذیری و برخورداری از کتابخانه های تخصصی، یکی از زبان های پرکاربرد در این حوزه است.
در این آموزش با مشاغل مرتبط با علم داده و مسیرهای شغلی این حوزه آشنا می شوید و یاد می گیرید چرا Python انتخاب مناسبی برای تحلیل اطلاعات است. همچنین با نقشه راه کلی فعالیت های مرتبط با علم داده آشنا خواهید شد و می توانید درک بهتری از ارتباط میان آماده سازی داده، مصورسازی، تحلیل آماری و یادگیری ماشین به دست آورید. این شناخت به شما کمک می کند جایگاه هر مهارت را در فرایند کار با داده بهتر درک کنید.
آماده سازی و پاک سازی داده ها با NumPy و pandas
پیش از تحلیل داده ها، باید اطلاعات خام را به شکلی مناسب آماده کرد. داده های واقعی معمولاً شامل مقادیر ناقص، رکوردهای تکراری یا ساختارهای نامنظم هستند و بدون پاک سازی نمی توان همیشه نتایج قابل اعتمادی از آن ها به دست آورد. کتابخانه های NumPy و pandas ابزارهای مهم Python برای کار با داده های عددی و جدولی هستند و امکانات متنوعی برای انتخاب، فیلتر کردن، تغییر و سازمان دهی اطلاعات در اختیار برنامه نویسان قرار می دهند.
در این بخش با عملیات اصلی آماده سازی داده آشنا می شوید. یاد می گیرید چگونه ردیف ها و ستون های موردنظر را انتخاب کنید، مقادیر گمشده را مدیریت کنید، داده های تکراری را حذف کنید و مجموعه های مختلف را به یکدیگر متصل کنید. همچنین تبدیل داده ها، گروه بندی اطلاعات و محاسبه مقادیر تجمیعی را تمرین می کنید. این مهارت ها پایه ای ضروری برای انجام تحلیل های دقیق تر و آماده کردن داده برای مراحل بعدی هستند.
مصورسازی داده ها با Matplotlib و Seaborn
مصورسازی داده یا Data Visualization یکی از بخش های مهم علم داده است؛ زیرا بررسی حجم زیادی از اطلاعات در قالب جدول همیشه آسان نیست. نمودارها کمک می کنند روندها، تفاوت ها، الگوها و ارتباط میان متغیرها را سریع تر تشخیص دهید. انتخاب نوع مناسب نمودار نیز اهمیت زیادی دارد؛ زیرا هر نوع داده و هر هدف تحلیلی ممکن است به شیوه متفاوتی از نمایش نیاز داشته باشد. استفاده درست از رنگ، عنوان و زمینه نیز در انتقال بهتر پیام نمودار مؤثر است.
در ادامه با کتابخانه های Matplotlib و Seaborn در Python کار می کنید و ساخت نمودارهای متداول را یاد می گیرید. تنظیم اجزای نمودار، قالب بندی، اضافه کردن برچسب ها و توضیحات، نمایش داده های سری زمانی و ترسیم نمودارهای آماری از جمله مهارت هایی هستند که در این بخش پوشش داده می شوند. با یادگیری این ابزارها می توانید نتایج تحلیل خود را به شکل بصری و قابل فهم تری ارائه کنید.
تحلیل اکتشافی داده ها (Exploratory Data Analysis) چیست؟
تحلیل اکتشافی داده یا EDA فرایندی برای شناخت بهتر یک مجموعه داده پیش از انجام تحلیل های پیشرفته تر یا ساخت مدل های یادگیری ماشین است. در این مرحله با استفاده از محاسبات ساده، آمار توصیفی و بررسی توزیع اطلاعات می توان ویژگی های اصلی داده ها را شناسایی کرد. همچنین بررسی داده های عددی و دسته ای به شما کمک می کند تصویری روشن تر از ساختار اطلاعات و روابط احتمالی میان متغیرها داشته باشید.
در این دوره با محاسبه آمار خلاصه، تحلیل داده های دسته ای و بررسی همبستگی میان متغیرها آشنا می شوید. روش هایی مانند همبستگی Pearson، همبستگی رتبه ای Spearman و آزمون Chi-square برای بررسی روابط آماری معرفی می شوند. همچنین با تحلیل مقادیر بسیار بزرگ یا کوچک و روش های چندمتغیره برای شناسایی داده های پرت (Outliers) آشنا خواهید شد. این بررسی ها به تشخیص مشکلات احتمالی داده و انتخاب روش مناسب برای تحلیل کمک می کنند.
مبانی یادگیری ماشین و آماده سازی داده برای مدل سازی
یادگیری ماشین (Machine Learning) شاخه ای از هوش مصنوعی است که در آن الگوریتم ها با استفاده از داده ها الگوهای موجود را یاد می گیرند و بر اساس آن ها پیش بینی یا دسته بندی انجام می دهند. کیفیت داده های ورودی نقش مهمی در عملکرد مدل های یادگیری ماشین دارد. به همین دلیل، آماده سازی مناسب داده ها، اصلاح مقادیر نامعتبر و انتخاب شکل مناسب برای نمایش متغیرها از مراحل مهم پیش از آموزش مدل هستند.
در این بخش با آماده سازی داده ها برای شروع پروژه های یادگیری ماشین آشنا می شوید. مدیریت و پاک سازی متغیرهای دسته ای (Categorical Variables) و تغییر توزیع مجموعه داده ها از جمله موضوعات مورد بررسی هستند. همچنین یک مسئله مقدماتی یادگیری ماشین را به صورت کاربردی بررسی می کنید تا با نحوه شروع یک مسئله واقعی و ارتباط میان مراحل آماده سازی داده و مدل سازی آشنا شوید.
جمع آوری داده از وب با Web Scraping و Python
گاهی اطلاعات موردنیاز برای تحلیل در فایل های محلی یا پایگاه های داده در دسترس نیستند و باید آن ها را از صفحات وب جمع آوری کرد. Web Scraping روشی برای استخراج خودکار اطلاعات از وب سایت هاست که می تواند در تهیه مجموعه داده برای تحلیل و تحقیقات داده محور کاربرد داشته باشد. Python با برخورداری از کتابخانه های مختلف، ابزارهای مناسبی برای ارسال درخواست های HTTP، دریافت محتوای صفحات و استخراج اطلاعات موردنظر فراهم می کند.
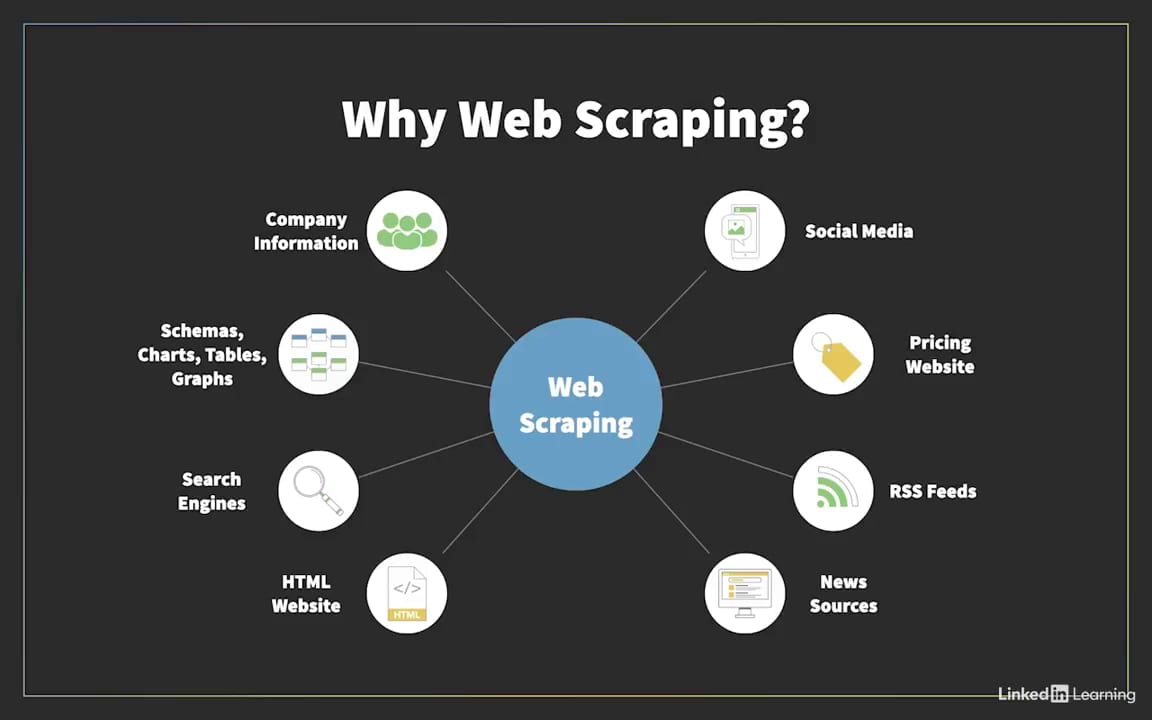
در این بخش با کتابخانه Requests برای خودکارسازی جمع آوری اطلاعات و ابزار BeautifulSoup برای پردازش محتوای HTML آشنا می شوید. ساختار اشیای BeautifulSoup، کار با NavigableString، تجزیه اطلاعات و اجرای یک فرایند واقعی Web Scraping از موضوعات این قسمت هستند. همچنین روش Asynchronous Scraping را بررسی می کنید تا با امکان جمع آوری هم زمان اطلاعات و کاربرد آن در فرایندهای استخراج داده آشنا شوید.
ساخت داشبوردهای تعاملی با Streamlit و آمادگی برای ورود به بازار کار
Streamlit یک کتابخانه Python برای ساخت برنامه های تحت وب تعاملی، به ویژه در پروژه های علم داده و تحلیل اطلاعات است. با استفاده از آن می توانید نتایج تحلیل ها و نمودارهای خود را در قالب یک رابط کاربری ساده نمایش دهید، بدون اینکه برای ساخت یک داشبورد تحلیلی به توسعه جداگانه یک Frontend پیچیده نیاز داشته باشید. این ابزار امکان ارائه بهتر نتایج تحلیل را برای همکاران و سایر کاربران فراهم می کند.
در بخش پایانی آموزش با راه اندازی محیط Streamlit و ساخت نمودارهای مختلف با آن کار می کنید. ایجاد نمودارهای پایه، نمودارهای خطی، میله ای، دایره ای و نمودارهای آماری از جمله مباحث این قسمت هستند. در پایان نیز با موضوعاتی مانند آماده سازی Portfolio و آمادگی شغلی آشنا می شوید و مسیرهای بعدی برای ادامه یادگیری را بررسی می کنید. محتوای این دوره به زبان انگلیسی ارائه شده و دارای زیرنویس انگلیسی است.
سرفصل مطالب آموزش ویدئویی کاربردی Python برای علم داده و یادگیری ماشین (بخش اول)
فصل اول: مقدمه
- ترفندهای کاربردی برای کار در علم داده
- نحوه استفاده از Codespaces در این دوره
فصل دوم: آشنایی با مشاغل حوزه داده
- مقدمهای بر مشاغل حوزه داده
- مسیرهای شغلی علم داده؛ شناسایی زمینه مناسب برای پیشرفت و موفقیت
- چرا برای تحلیل داده از Python استفاده کنیم؟
- نقشه راه کلی دوره
فصل سوم: مبانی آمادهسازی دادهها
- مقدمهای بر آمادهسازی دادهها
- مبانی NumPy و pandas
- فیلتر کردن و انتخاب دادهها
- مدیریت مقادیر گمشده
- حذف دادههای تکراری
- ادغام و تبدیل دادهها
- گروهبندی و تجمیع دادهها
فصل چهارم: مبانی مصورسازی دادهها
- اهمیت مصورسازی در علم داده
- سه نوع مصورسازی داده
- انتخاب نمودارهای مناسب برای نمایش دادهها
- انتقال مفاهیم با استفاده از رنگ و زمینه
فصل پنجم: مصورسازی عملی دادهها
- مقدمهای بر کتابخانههای matplotlib و Seaborn
- ایجاد نمودارهای استاندارد داده
- تعریف اجزای یک نمودار
- قالببندی نمودارها
- ایجاد برچسبها و توضیحات روی نمودار
- مصورسازی دادههای سری زمانی
- ایجاد نمودارهای آماری با Seaborn
فصل ششم: تحلیل اکتشافی دادهها
- محاسبات ساده ریاضی
- تولید آمارهای خلاصه
- خلاصهسازی دادههای دستهای
- تحلیل همبستگی Pearson
- همبستگی رتبهای Spearman و آزمون Chi-square
- تحلیل مقادیر حدی برای شناسایی دادههای پرت
- تحلیل چندمتغیره برای شناسایی دادههای پرت
فصل هفتم: شروع کار با یادگیری ماشین
- پاکسازی و مدیریت متغیرهای دستهای
- تبدیل توزیع مجموعه دادهها
- حل یک مسئله مقدماتی یادگیری ماشین بهصورت عملی
فصل هشتم: جمعآوری داده از طریق Web Scraping
- مقدمهای بر Web Scraping
- استفاده از Python Requests برای خودکارسازی جمعآوری دادهها
- شیء BeautifulSoup
- اشیای NavigableString
- تجزیه و پردازش دادهها
- اجرای عملی Web Scraping
- استخراج ناهمگام دادهها
فصل نهم: تحلیل مشارکتی دادهها با Streamlit
- مقدمهای بر Streamlit
- آمادهسازی محیط توسعه
- ایجاد نمودارهای پایه
- ایجاد نمودارهای خطی در Streamlit
- ایجاد نمودارهای میلهای و دایرهای در Streamlit
- ایجاد نمودارهای آماری
فصل دهم: جمعبندی
- آمادهسازی Portfolio و آمادگی شغلی
- گامهای بعدی
محصولات مرتبط