پرووید

آموزش خلاصه سازی متن با هوش مصنوعی Hugging Face
آموزش خلاصهسازی متن با هوش مصنوعی و Hugging Face با عنوان اصلی AI Text Summarization with Hugging Face یکی دیگر از آموزشهای گروه آموزشی پرووید میباشد که در این قسمت آن را به شما معرفی میکنیم. در این دوره، روشهای مختلف خلاصهسازی متن با استفاده از تکنیکهای هوش مصنوعی و ابزارهای Hugging Face بررسی میشوند و مخاطب با رویکردهای Extractive و Abstractive، مدلهای Transformer، معیارهای ارزیابی خلاصهها و Fine-Tuning مدلها آشنا میشود.
آشنایی با روشهای خلاصهسازی متن
در ابتدای دوره، مفهوم Extractive Text Summarization بررسی میشود؛ روشی که با انتخاب بخشهای مهم متن، خلاصهای از محتوای اصلی ایجاد میکند. در ادامه، Intermediate Representationها و معیارهای ارزیابی خلاصهها مورد بررسی قرار میگیرند و نحوه استفاده از کتابخانه sumy و قابلیتهای Hugging Face برای انجام خلاصهسازی Extractive آموزش داده میشود. سپس رویکرد Abstractive Text Summarization معرفی میشود که با استفاده از مدلهای زبانی میتواند خلاصهای جدید بر اساس مفهوم متن تولید کند.
استفاده از Transformerها و Hugging Face برای خلاصهسازی
بخش مهمی از دوره به درک ساختار Transformerها اختصاص دارد. مخاطب با Sequence-to-Sequence Models، مفهوم Attention و نحوه استفاده از Transformerها در Hugging Face آشنا میشود.
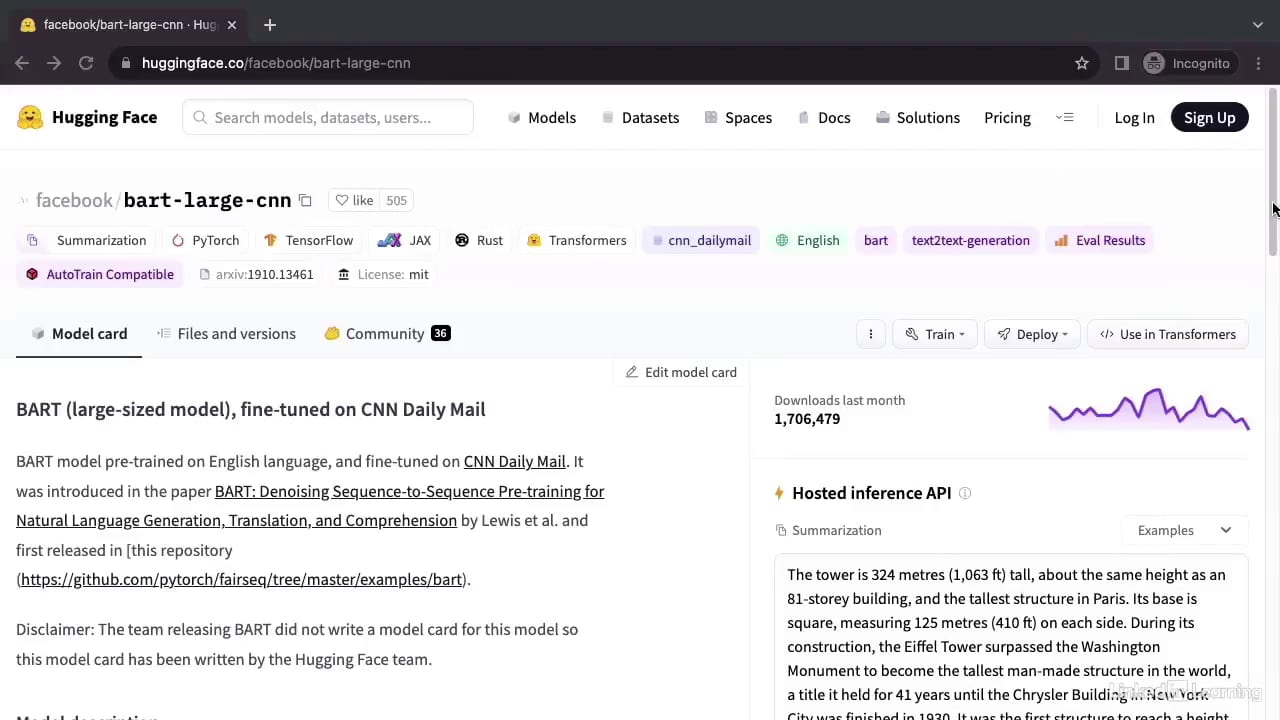
سپس با استفاده از Google Colab و دیتاست CNN Daily Mail، دادههای متنی آماده و پاکسازی شده و خلاصهها با استفاده از Hugging Face Transformers تولید میشوند. همچنین نحوه ارزیابی خلاصههای تولیدشده با معیار ROUGE و محاسبه امتیازهای تجمیعی ROUGE بررسی میشود.
Fine-Tuning و مقایسه مدلهای مختلف برای خلاصهسازی
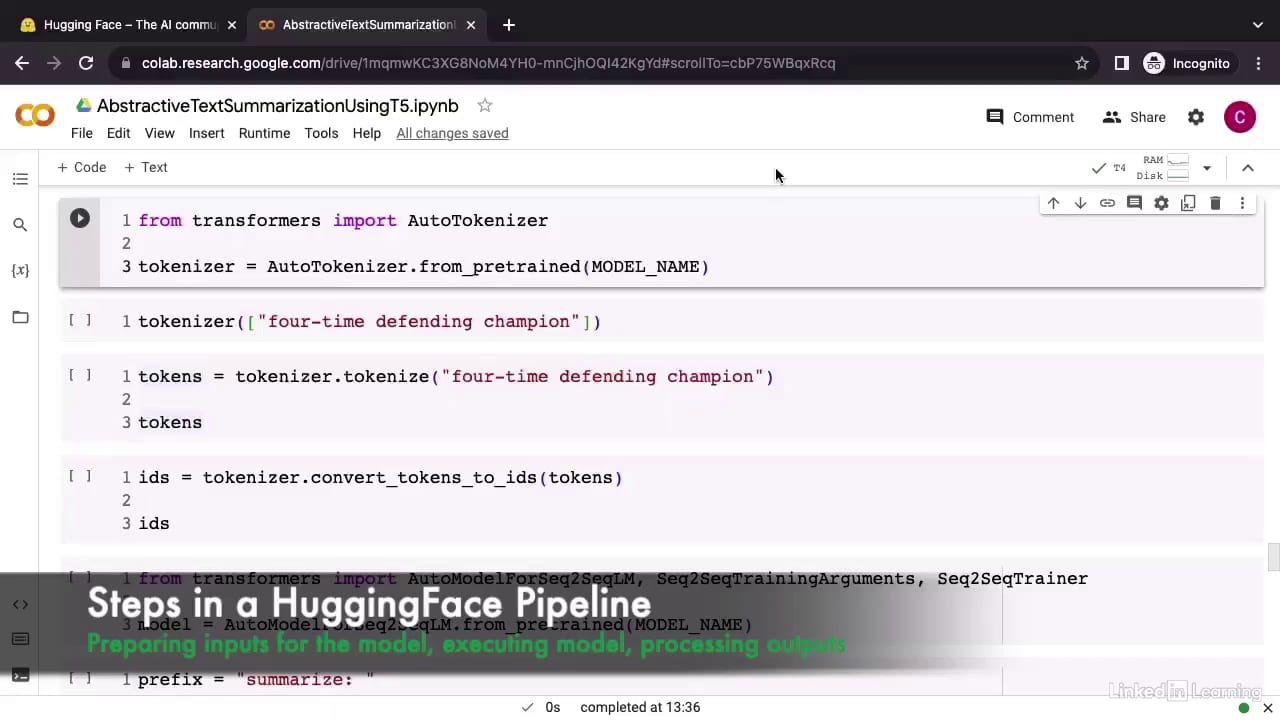
در ادامه، Tokenizerها معرفی میشوند و یک مدل T5 small برای انجام وظیفه خلاصهسازی Fine-Tune میشود. سپس مدل آموزشدیده در Hugging Face Hub قرار میگیرد و برای تولید خلاصه مورد استفاده قرار میگیرد.
در بخش پایانی، مدلهایی مانند Pegasus و BART روی مجموعه داده BBC News بررسی میشوند و نحوه تولید چندین خلاصه و محاسبه معیارهای ROUGE برای مقایسه نتایج آنها آموزش داده میشود.
کاربرد خلاصهسازی خودکار متن در پروژههای هوش مصنوعی
خلاصهسازی خودکار متن یکی از کاربردهای پردازش زبان طبیعی یا NLP است که با هدف استخراج محتوای مهم از متنهای طولانی انجام میشود. این فناوری میتواند در پردازش مقالهها، گزارشها، اسناد و محتوای متنی گسترده مورد استفاده قرار بگیرد. بهجای مطالعه کامل همه مطالب، کاربران میتوانند ابتدا خلاصهای از نکات اصلی را بررسی کنند و سپس در صورت نیاز به سراغ بخشهای جزئیتر بروند.
در پروژههای مبتنی بر هوش مصنوعی، خلاصهسازی متن میتواند بخشی از سامانههای مدیریت محتوا، تحلیل اسناد و بازیابی اطلاعات باشد. کیفیت خروجی به عواملی مانند ساختار متن ورودی، انتخاب مدل و معیارهای ارزیابی وابسته است. همچنین خلاصه باید اطلاعات اصلی را حفظ کند و از حذف نکات ضروری یا ایجاد برداشت نادرست جلوگیری شود. شناخت این ملاحظات به توسعهدهندگان کمک میکند راهکارهای خلاصهسازی را متناسب با نیاز واقعی برنامه انتخاب و ارزیابی کنند.
کتابخانه sumy در پردازش متن چه کاربردی دارد؟
sumy یک کتابخانه Python برای خلاصهسازی خودکار متن است که از روشهای مختلف خلاصهسازی استخراجی پشتیبانی میکند. در این رویکرد، سیستم بهجای تولید جملههای کاملاً جدید، جملههای مهم متن اصلی را انتخاب میکند و با کنار هم قرار دادن آنها خلاصهای از محتوا میسازد. این روش میتواند برای آشنایی با اصول خلاصهسازی ماشینی و ساخت نمونههای اولیه پردازش متن مفید باشد.
هنگام استفاده از sumy، عواملی مانند تعداد جملههای خروجی، روش انتخاب جملهها و ویژگیهای متن ورودی بر نتیجه تأثیر میگذارند. خلاصه استخراجی ممکن است از نظر انسجام یا روانی به ویرایش بیشتری نیاز داشته باشد، زیرا جملهها لزوماً برای قرار گرفتن در کنار یکدیگر بازنویسی نمیشوند. آشنایی با چنین کتابخانههایی به برنامهنویسان کمک میکند تفاوت روشهای سنتی و مدلهای مبتنی بر یادگیری عمیق را بهتر درک کنند و راهکار مناسبتری برای پروژه خود انتخاب کنند.
چگونه کیفیت خلاصههای تولیدشده را ارزیابی کنیم؟
ارزیابی خلاصههای متنی یکی از مراحل مهم توسعه سامانههای خلاصهسازی است. کوتاه بودن خروجی بهتنهایی نشاندهنده کیفیت مناسب نیست؛ یک خلاصه خوب باید اطلاعات کلیدی متن را حفظ کند، از جزئیات کماهمیت فاصله بگیرد و تا حد امکان معنای اصلی محتوا را تغییر ندهد. برای ارزیابی دقیقتر میتوان خلاصه تولیدشده را با خلاصه مرجع مقایسه کرد و میزان پوشش اطلاعات مهم و تناسب آن با هدف کاربرد را سنجید.
معیارهایی مانند ROUGE برای بررسی میزان همپوشانی واژگانی میان خلاصه تولیدشده و خلاصه مرجع کاربرد دارند، اما بهتنهایی تمام جنبههای کیفیت معنایی و خوانایی را پوشش نمیدهند. بنابراین، در انتخاب روش ارزیابی باید نوع متن، کاربرد نهایی و نیازهای کاربران در نظر گرفته شوند. مقایسه نتایج چند مدل با استفاده از معیارهای یکسان میتواند درک روشنتری از نقاط قوت و محدودیتهای هر روش ایجاد کند و تصمیمگیری درباره انتخاب مدل را بهبود دهد.
سرفصل مطالب آموزش ویدئویی خلاصهسازی متن با هوش مصنوعی و Hugging Face
فصل اول: مقدمه
- خلاصهسازی متن با هوش مصنوعی و Hugging Face
فصل دوم: آشنایی با Extractive Text Summarization
- پیشنیازها
- خلاصهسازی Extractive متن
- Intermediate Representationها برای خلاصهسازی Extractive
- معیارهای ارزیابی خلاصهها
فصل سوم: انجام خلاصهسازی Extractive با استفاده از Hugging Face
- آشنایی با Hugging Face
- ثبتنام در Hugging Face
- کتابخانه sumy برای خلاصهسازی Extractive
- خلاصهسازی Extractive متن در Hugging Face
فصل چهارم: آشنایی با Abstractive Text Summarization
- خلاصهسازی Abstractive متن
- خلاصهسازی Abstractive با استفاده از Hosted Inference API در Hugging Face
فصل پنجم: آشنایی با Transformerها
- مدلهای Sequence-to-Sequence
- Attention در مدلهای Sequence-to-Sequence
- معرفی مختصر Transformerها
- Transformerها در Hugging Face
فصل ششم: انجام خلاصهسازی با استفاده از Hugging Face Pipeline
- استفاده از Colab برای کار با Hugging Face Transformers
- بارگذاری دیتاست CNN Daily Mail
- پاکسازی دادههای متنی
- تولید خلاصه با Hugging Face Transformers
- ارزیابی خلاصهها با استفاده از امتیازهای ROUGE
- خلاصهسازی متن و محاسبه امتیازهای تجمیعی ROUGE
فصل هفتم: Fine-Tuning یک مدل Transformer برای خلاصهسازی
- آشنایی با Tokenizerها
- Fine-Tuning مدل T5 small
- انتقال مدل به Hugging Face Hub
- خلاصهسازی متن با استفاده از مدل Fine-Tune شده
فصل هشتم: بررسی Transformerهای مختلف Hugging Face برای خلاصهسازی
- دسترسی به دیتاست BBC در Google Drive
- ایجاد نمونه و پاکسازی دیتاست خلاصههای BBC News
- تولید خلاصه با استفاده از Pegasus
- تولید چندین خلاصه و محاسبه امتیازهای تجمیعی ROUGE
- تولید خلاصه با استفاده از BART
- محاسبه معیارهای ROUGE برای مجموعهای از خلاصهها
فصل نهم: جمعبندی
- جمعبندی و گامهای بعدی
محصولات مرتبط